AI エージェントに FIT ファイル解析を任せて、サイコン内部仕様を逆算してみた
はじめに
サイクルコンピュータ(Bryton)が表示する平均ケイデンス・走行時間・平均速度の計算はブラックボックスです。これらの値が FIT ファイルのどのデータから、どのように計算されているのか?メーカーは内部仕様を公開していないため、実際の FIT ファイルを解析しないとわかりません。そこで今回は、
vscode + cline + openrouter + tencent/hy3-preview
という AI エージェント環境を使い、調査・実験を丸投げして内部仕様を推定してみました。
使用した AI エージェント環境
今回の調査は、以下の構成で AI に実験を実行させた。
- Code + cline
- OpenRouter 経由で tencent/hy3-preview モデルを使用
- エージェントに「調査 → 実装 → 実行 → 推定」を丸ごと任せる
与えたプロンプトは以下の通り:
- FIT の Record(1秒ごと)から
- 平均ケイデンス
- 走行時間
- 平均速度
を計算する方法を調査せよ
平均ケイデンスとは何か?
走行時間の判定(速度しきい値)は?
FIT の Session(集計)と Record(時系列)の関係を理解した上で Record から Session の値を再現する Go プログラムを実装せよ
サンプル FIT を使って検証せよ
AIエージェントに調査させた内容
sequenceDiagram
    participant U as User
    participant A as AI Agent
    participant G as Go Program

    U->>A: FIT の集計ロジックを調査せよ
    A->>A: FIT 仕様を整理(Session / Record)
    A->>A: 計算ロジックの仮説を立てる
    A->>G: Go コードを自動生成
    G->>A: FIT を解析した結果を返す
    A->>A: Session と Record の整合性を検証
    A->>U: 推定された内部仕様をレポート
FIT ファイルの構造(Session / Record)
AI エージェントはまず FIT の構造を整理した。
flowchart TD

A[FIT File] --> B[Session Message<br>集計データ]
A --> C[Record Message<br>1秒ごとの時系列データ]

B --> B1[total_timer_time<br>走行時間]
B --> B2[total_distance<br>総距離]
B --> B3[avg_speed<br>平均速度]
B --> B4[avg_cadence<br>平均ケイデンス]

C --> C1[timestamp]
C --> C2[speed]
C --> C3[distance]
C --> C4[cadence]
C --> C5[GPS / HR / Altitude]
AI が生成した Go 実験プログラム
AI は Go 言語で以下を行うプログラムを自動生成した。
- FIT の Session 値を読み取る
- Record の速度・距離・ケイデンスを単位変換
- 速度しきい値を 0〜10 km/h で総当たりし、Session.TotalTimerTime に最も近い値を探索
- 平均速度・平均ケイデンスを計算し Session と比較
- 速度分布・ケイデンス分布を可視化
コード抜粋(Record の単位変換)
// Convert FIT record fields
speedKmh := float64(r.Speed) * 0.0036        // 0.001 m/s → km/h
distKm   := float64(r.Distance) / 100000.0   // cm → km

recordData[i] = RecordData{
    Timestamp: r.Timestamp,
    Speed:     speedKmh,
    Distance:  distKm,
    Cadence:   r.Cadence,
}
コード抜粋(速度しきい値の総当たり探索)
bestTh := 0.0
bestDiff := 1e9

for th := 0.0; th <= 10.0; th += 0.1 {
    count := 0
    for _, rd := range recordData {
        if rd.Speed > th {
            count++
        }
    }
    diff := math.Abs(float64(count) - sessionTotalTimerSec)
    if diff < bestDiff {
        bestDiff = diff
        bestTh = th
    }
}
コード抜粋(平均ケイデンスの計算)
var sum uint64
var count int

for _, rd := range movingRecords {
    if rd.Cadence > 0 && int(rd.Cadence) <= cadenceMax {
        sum += uint64(rd.Cadence)
        count++
    }
}

avgCadence := float64(sum) / float64(count)
結論
サイコン(bryton)がFITファイルのRecordメッセージから集計データを計算するロジックは以下の通りです。
| 項目 | 計算ロジック | 備考 |
|---|---|---|
| 走行時間 | 速度 > 0.5 km/h のレコード数(秒) | Session.TotalTimerTimeに一致 |
| 平均速度 | 総距離 ÷ (走行時間 ÷ 3600) [km/h] | Session.AvgSpeedに一致 |
| 平均ケイデンス | 走行レコード(速度 > 0.5 km/h のレコード)のうちケイデンス>0かつ≤200 rpmの平均値 | Session.AvgCadenceにほぼ一致 |
今回の実験では、AI エージェントに FIT ファイル解析とロジック推定を任せたところ、
- 速度しきい値の自動探索
- 平均速度・平均ケイデンスの逆算
- Session と Record の整合性チェック
- Go コードの自動生成
- 結果のレポート化
までを自動で行い、サイコン内部仕様を再現することに成功しました。 AI を使うことで、「ブラックボックス化されたデバイスの内部仕様を逆算する」という作業が効率化できたかな?
(AIが生成した)全コード
実行方法:
go run main.go <FITファイル> [速度閾値] [最大ケイデンス]
例:
go run main.go data/260428131612.fit 0.5 200
出力にはSession値との比較、速度分布、ケイデンス分布などが表示される。
package main

import (
    "fmt"
    "log"
    "os"
    "sort"
    "time"

    "github.com/tormoder/fit"
)

func main() {
    // コマンドライン引数のチェック
    if len(os.Args) < 2 {
        fmt.Println("Usage: fitcalc <fitfile> [speed_threshold] [cadence_max]")
        fmt.Println("  speed_threshold: speed threshold for moving (default auto-detect)")
        fmt.Println("  cadence_max: max cadence to consider valid (default 200 rpm)")
        os.Exit(1)
    }
    fitFile := os.Args[1]
    speedThreshold := -1.0 // 負の値の場合は自動検出
    cadenceMax := 200      // rpm
    if len(os.Args) > 2 {
        fmt.Sscanf(os.Args[2], "%f", &speedThreshold)
    }
    if len(os.Args) > 3 {
        fmt.Sscanf(os.Args[3], "%d", &cadenceMax)
    }

    // FITファイルを開く
    f, err := os.Open(fitFile)
    if err != nil {
        log.Fatalf("Failed to open FIT file: %v", err)
    }
    defer f.Close()

    // FITファイルをデコード
    fitData, err := fit.Decode(f)
    if err != nil {
        log.Fatalf("Failed to decode FIT file: %v", err)
    }

    // アクティビティデータを取得
    activity, err := fitData.Activity()
    if err != nil {
        log.Fatalf("Failed to get activity: %v", err)
    }

    if len(activity.Sessions) == 0 {
        fmt.Println("No sessions found")
        return
    }
    session := activity.Sessions[0]

    // Sessionの値を表示(正しい単位変換)
    sessionTotalTimerMs := uint32(session.TotalTimerTime)
    sessionTotalTimerSec := float64(sessionTotalTimerMs) / 1000.0
    sessionDistCm := uint32(session.TotalDistance)
    sessionDistKm := float64(sessionDistCm) / 100000.0
    sessionAvgSpeedRaw := uint16(session.AvgSpeed)
    sessionAvgSpeedKmh := float64(sessionAvgSpeedRaw) * 0.001 * 3.6
    sessionAvgCadence := uint8(session.AvgCadence)

    fmt.Println("=== Session Values (from FIT file) ===")
    // formatDuration をインラインで定義
    formatDuration := func(seconds float64) string {
        h := int(seconds) / 3600
        m := (int(seconds) % 3600) / 60
        s := int(seconds) % 60
        return fmt.Sprintf("%d:%02d:%02d", h, m, s)
    }
    fmt.Printf("  TotalTimerTime: %.0f seconds (%s)\n", sessionTotalTimerSec, formatDuration(sessionTotalTimerSec))
    fmt.Printf("  TotalDistance: %.2f km\n", sessionDistKm)
    fmt.Printf("  AvgSpeed: %.2f km/h (raw: %d)\n", sessionAvgSpeedKmh, sessionAvgSpeedRaw)
    fmt.Printf("  AvgCadence: %d rpm\n\n", sessionAvgCadence)

    // Recordデータを取得
    records := activity.Records
    if len(records) == 0 {
        fmt.Println("No records found")
        return
    }
    fmt.Printf("Total records: %d\n\n", len(records))

    // Recordデータを構造化し、単位変換を行う
    type RecordData struct {
        Timestamp time.Time
        Speed     float64 // km/h
        Distance  float64 // km
        Cadence   uint8   // rpm
    }
    recordData := make([]RecordData, len(records))
    for i, r := range records {
        // 速度: uint16, 0.001 m/s -> km/h
        speedKmh := float64(r.Speed) * 0.0036
        // 距離: uint32, cm -> km
        distKm := float64(r.Distance) / 100000.0
        recordData[i] = RecordData{
            Timestamp: r.Timestamp,
            Speed:     speedKmh,
            Distance:  distKm,
            Cadence:   r.Cadence,
        }
    }

    // 走行/停止の閾値を探索(SessionのTotalTimerTimeに最も近くなる閾値を見つける)
    fmt.Println("=== Searching for best speed threshold ===")
    bestTh := 0.0
    bestDiff := 1e9
    for th := 0.0; th <= 10.0; th += 0.1 {
        count := 0
        for _, rd := range recordData {
            if rd.Speed > th {
                count++
            }
        }
        diff := float64(count) - sessionTotalTimerSec
        if diff < 0 {
            diff = -diff
        }
        if diff < bestDiff {
            bestDiff = diff
            bestTh = th
        }
    }
    fmt.Printf("Best threshold to match TotalTimerTime: %.1f km/h (diff: %.0f seconds)\n\n", bestTh, bestDiff)

    // 指定された閾値(または最適閾値)で移動記録を抽出
    threshold := speedThreshold
    if threshold < 0 {
        // デフォルトの場合は最適閾値を使用
        threshold = bestTh
    }
    fmt.Printf("=== Calculation with threshold %.1f km/h ===\n", threshold)
    var movingRecords []RecordData
    for _, rd := range recordData {
        if rd.Speed > threshold {
            movingRecords = append(movingRecords, rd)
        }
    }
    movingTimeSec := len(movingRecords) // 1 record per second
    fmt.Printf("Moving records: %d (time: %s)\n", movingTimeSec, formatDuration(float64(movingTimeSec)))
    fmt.Printf("Session TotalTimerTime: %.0f seconds (%s)\n", sessionTotalTimerSec, formatDuration(sessionTotalTimerSec))

    // 平均速度の計算(総距離 / 走行時間)
    totalDist := recordData[len(recordData)-1].Distance
    movingTimeHour := float64(movingTimeSec) / 3600.0
    avgSpeedCalc := totalDist / movingTimeHour
    fmt.Printf("Total distance: %.2f km\n", totalDist)
    fmt.Printf("Average speed (distance/time): %.2f km/h (session: %.2f)\n", avgSpeedCalc, sessionAvgSpeedKmh)

    // 平均ケイデンスの計算
    // Session.AvgCadenceは、移動記録(速度 > 閾値)のうち、
    // ケイデンスが0以外かつ異常値(例: 255 rpm)を除外した平均値と一致する。
    // したがって、計算にはケイデンス > 0 かつ <= cadenceMax の記録のみを使用する。
    var sumValid uint64
    var countValid int
    for _, rd := range movingRecords {
        if rd.Cadence > 0 && int(rd.Cadence) <= cadenceMax {
            sumValid += uint64(rd.Cadence)
            countValid++
        }
    }
    avgValid := 0.0
    if countValid > 0 {
        avgValid = float64(sumValid) / float64(countValid)
    }
    fmt.Printf("Avg cadence (non-zero, <= %d rpm): %.1f rpm (session: %d)\n", cadenceMax, avgValid, sessionAvgCadence)

    // ケイデンス分布の表示(異常値除外)
    fmt.Printf("\n=== Cadence Distribution (moving records, threshold %.1f km/h, cadence <= %d) ===\n", threshold, cadenceMax)
    cadenceBuckets := make(map[int]int) // 5 rpmごとに集計
    for _, rd := range movingRecords {
        if int(rd.Cadence) <= cadenceMax {
            bucket := int(rd.Cadence / 5)
            cadenceBuckets[bucket]++
        }
    }
    keys := make([]int, 0, len(cadenceBuckets))
    for k := range cadenceBuckets {
        keys = append(keys, k)
    }
    sort.Ints(keys)
    for _, k := range keys {
        min := k * 5
        max := (k + 1) * 5
        fmt.Printf("  %3d-%3d rpm: %d records\n", min, max, cadenceBuckets[k])
    }

    // 速度分布の表示(低速度域)
    fmt.Printf("\n=== Speed Distribution (0-10 km/h) ===\n")
    speedBuckets := make(map[int]int) // 0.5 km/hごとに集計
    for _, rd := range recordData {
        if rd.Speed < 10.0 {
            bucket := int(rd.Speed / 0.5)
            speedBuckets[bucket]++
        }
    }
    speedKeys := make([]int, 0, len(speedBuckets))
    for k := range speedBuckets {
        speedKeys = append(speedKeys, k)
    }
    sort.Ints(speedKeys)
    for _, k := range speedKeys {
        min := float64(k) * 0.5
        max := float64(k+1) * 0.5
        fmt.Printf("  %4.1f-%4.1f km/h: %d records\n", min, max, speedBuckets[k])
    }

    // 結論:Sessionの値との比較
    fmt.Printf("\n=== Conclusion ===\n")
    fmt.Printf("Speed threshold for moving: %.1f km/h\n", threshold)
    fmt.Printf("Moving time: %s (session: %s, diff: %.0f sec)\n",
        formatDuration(float64(movingTimeSec)), formatDuration(sessionTotalTimerSec),
        float64(movingTimeSec)-sessionTotalTimerSec)
    fmt.Printf("Average speed: %.2f km/h (session: %.2f)\n", avgSpeedCalc, sessionAvgSpeedKmh)
    fmt.Printf("Average cadence (non-zero, valid): %.1f rpm (session: %d)\n", avgValid, sessionAvgCadence)
    fmt.Printf("Average cadence (non-zero, valid) / 2: %.1f rpm\n", avgValid/2)
}
go言語で挑戦:獲得標高とFITファイルの解析(3) hysteresis
はじめに
前回、Savitzky–Golayフィルタを導入して標高データの形状をできるだけ保ちながら平滑化を試みました。しかし、実際に複数のFITファイルで獲得標高を計算してみると、サイコン本体の表示値との誤差がまだ残るケースが目立ちました。
特に問題だったのは以下の2点です:
- 平坦路や緩やかなローリングヒルで微小な上下動(ノイズ)が過剰にカウントされ、獲得標高が過大になる
- 一方で、急峻なヒルクライムでは比較的良好に一致する
単純に「現在の高度 - 前の高度 > minDiff なら加算」という方法では、微細な揺らぎや路面の凹凸が積み重なってしまい、 現実の「登った感覚」と乖離してしまいます。
そこで導入したのがヒステリシス(hysteresis)付きの区間ベース上昇検出です。
ヒステリシスロジックとは
ヒステリシスとは、「状態が変化する際に、上昇時と下降時で異なる閾値を用いる」 手法です。これにより、小さなジグザグを無視しつつ、意味のある連続した上昇区間だけをカウントできます。
- 上昇開始の判定: 直近の最低点から
ascThresholdメートル上昇したら「上昇開始」とみなす - 下降開始の判定: 直近の最高点から
descThresholdメートル下降したら「下降開始(上昇終了)」とみなす - ascThreshold > descThreshold とすることで、ノイズによる誤判定を防止する
アルゴリズムの詳細
状態遷移
アルゴリズムは2つの状態を持ちます:
- descending(下降中): 最低点(
lastLow)を更新しながら、上昇開始を待つ - ascending(上昇中): 最高点(
lastHigh)を更新しながら、下降開始を待つ
実装
state := "descending"
lastLow := altitudes[0]
lastHigh := altitudes[0]

for each point in smoothedAltitudes {
    current := point

    if state == "descending" {
        if current > lastLow + hystAsc {  // 上昇閾値を超えた
            state = "ascending"
            lastHigh = current
        } else {
            lastLow = min(lastLow, current)  // 下降中は最低点を更新
        }
    } else {  // ascending状態
        if current < lastHigh - hystDesc {  // 下降閾値を超えて下がった
            gain += lastHigh - lastLow       // 区間全体の上昇量を加算
            state = "descending"
            lastLow = current
        } else {
            lastHigh = max(lastHigh, current)  // 上昇中は最高点を更新
        }
    }
}

// 最後の区間が上昇中のまま終わった場合
if state == "ascending" {
    gain += lastHigh - lastLow
}
図解
標高
  ^
  |         /\ lastHigh
  |        /  \
  |       /    \      /\
  |      /      \    /  \
  |     /        \  /    \
  |    /          \/      \
  |   / lastLow            \
  |  /                      \
  +---------------------------> 時間
         |← asc →|
                 |← desc →|
- 下降中(
descending)に最低点(lastLow)を更新し続ける lastLow + ascThresholdを超えたら上昇状態に遷移- 上昇中(
ascending)に最高点(lastHigh)を更新し続ける lastHigh - descThresholdを下回ったら下降状態に遷移し、lastHigh - lastLowを獲得標高として加算
最適値を検索
go run main.go --tune --hyst-asc-min=2.0 --hyst-asc-max=3.0 --hyst-asc-step=0.2 --hyst-desc-min=1.0 --hyst-desc-max=2.5 --hyst-desc-step=0.2 Activities/*.fit
結果は、前回よりもサイコン本体の表示値に近づきました。
前回は、移動平均でスムージング後に単純に「現在の高度 - 前の高度 > minDiff なら加算」というロジックでした。
だいぶいい感じになりました。
実際の実験結果
ある走行で、以下の3つの獲得標高を比較してみました。
| 測定方法 | 獲得標高 |
|---|---|
| サイコン (Bryton Rider 320) | 629 m |
| スマホ Strava アプリ | 597 m |
| 本ツール (ヒステリシス方式) | 641.79 m |
パラメータ: hysteresis-asc=2.60, hysteresis-desc=2.40, window=17
サイコンと本ツールの計算値は約2%の差異に収まりました。 一方、スマホアプリ(Strava)はサイコンより約5%低い値を示しました。この差異は、GPSセンサーの精度差や、各サービス・デバイス独自の計算アルゴリズムの違いによるものと考えられます。
サイコンから得られた標高データから「獲得標高(Elevation Gain)」を正確に算出することは、 一見簡単そうに見えて実は難しい問題ですね。
| 項目 | フィルタ | 最適 window | 最適 hyst-asc | 最適 hyst-desc | 平均絶対誤差(MAE) |
|---|---|---|---|---|---|
| 前回(min-diff方式) | 移動平均 | 21 | na | na | 23.65 m |
| 今回(ヒステリシス方式) | 移動平均 | 17 | 2.60 | 2.40 | 12.68 m |
パラメータ探索結果 (--tune)
==================================================
対象ファイル数: 25
探索範囲: window=3..21 (奇数), hyst-asc=2.00..3.00 (step=0.20), hyst-desc=1.00..2.50 (step=0.20)
フィルタータイプ: ma
評価指標: MAE
最適 window: 17
最適 hyst-asc: 2.60
最適 hyst-desc: 2.40
平均絶対誤差(MAE): 12.68 m

ファイル別比較 (最適パラメータ適用)
--------------------------------------------------
251128104532.fit: ref=628, calc=640.98, diff=+12.98 (+2.07%)
251201074633.fit: ref=1442, calc=1434.35, diff=-7.65 (-0.53%)
251205095644.fit: ref=1056, calc=1054.22, diff=-1.78 (-0.17%)
251207101744.fit: ref=288, calc=293.21, diff=+5.21 (+1.81%)
251208101118.fit: ref=650, calc=645.99, diff=-4.01 (-0.62%)
251210095356.fit: ref=697, calc=692.48, diff=-4.52 (-0.65%)
251213100936.fit: ref=699, calc=694.16, diff=-4.84 (-0.69%)
251217075556.fit: ref=1506, calc=1471.28, diff=-34.72 (-2.31%)
251219102311.fit: ref=684, calc=692.35, diff=+8.35 (+1.22%)
251223111148.fit: ref=376, calc=377.68, diff=+1.68 (+0.45%)
251226095732.fit: ref=729, calc=713.98, diff=-15.02 (-2.06%)
251228063640.fit: ref=1138, calc=1161.04, diff=+23.04 (+2.02%)
251231095634.fit: ref=683, calc=687.21, diff=+4.21 (+0.62%)
260102085559.fit: ref=743, calc=750.87, diff=+7.87 (+1.06%)
260104110841.fit: ref=716, calc=739.68, diff=+23.68 (+3.31%)
260110110319.fit: ref=869, calc=829.67, diff=-39.33 (-4.53%)
260112090012.fit: ref=374, calc=380.16, diff=+6.16 (+1.65%)
260118061703.fit: ref=712, calc=712.59, diff=+0.59 (+0.08%)
260125062210.fit: ref=836, calc=855.41, diff=+19.41 (+2.32%)
260131092057.fit: ref=841, calc=848.52, diff=+7.52 (+0.89%)
260205062152.fit: ref=245, calc=234.36, diff=-10.64 (-4.34%)
260207053732.fit: ref=647, calc=665.87, diff=+18.87 (+2.92%)
260215063644.fit: ref=1460, calc=1450.52, diff=-9.48 (-0.65%)
260221070452.fit: ref=786, calc=787.99, diff=+1.99 (+0.25%)
260223080851.fit: ref=1309, calc=1265.63, diff=-43.37 (-3.31%)
全コード
package main

import (
    "encoding/csv"
    "flag"
    "fmt"
    "log"
    "math"
    "os"
    "path/filepath"
    "strings"

    "github.com/tormoder/fit"
    "gonum.org/v1/gonum/mat"
)

var sgCache = make(map[int]map[int][]float64)

const (
    movingAverageWindow = 21   // 移動平均の窓幅(奇数推奨)
    defaultFilterType   = "ma" // "ma" = moving average, "sg" = Savitzky-Golay
    defaultSGOrder      = 2    // Savitzky-Golay polynomial order
    defaultHystAsc      = 0.05 // ヒステリシス上昇閾値 (m) ※チューニングで最適値を探索可能
    defaultHystDesc     = 0.03 // ヒステリシス下降閾値 (m) ※チューニングで最適値を探索可能
)

// exportAltitudeCSV は生標高と平滑化標高をCSV出力する
func exportAltitudeCSV(filePath string, window int, filterType string, order int, outCSV string) error {
    file, err := os.Open(filePath)
    if err != nil {
        return err
    }
    defer file.Close()

    fitFile, err := fit.Decode(file)
    if err != nil {
        return err
    }
    activity, err := fitFile.Activity()
    if err != nil {
        return err
    }

    rawAltitudes := make([]float64, 0, len(activity.Records))
    for _, record := range activity.Records {
        if record.Altitude != 0xFFFF {
            rawAltitudes = append(rawAltitudes, float64(record.Altitude)/5.0-500.0)
        }
    }
    smoothedAltitudes := smoothValues(rawAltitudes, filterType, window, order)

    f, err := os.Create(outCSV)
    if err != nil {
        return err
    }
    defer f.Close()
    w := csv.NewWriter(f)
    defer w.Flush()
    w.Write([]string{"raw", "smoothed"})
    for i := 0; i < len(rawAltitudes) && i < len(smoothedAltitudes); i++ {
        w.Write([]string{
            fmt.Sprintf("%.3f", rawAltitudes[i]),
            fmt.Sprintf("%.3f", smoothedAltitudes[i]),
        })
    }
    return nil
}

// movingAverage は指定窓幅で標高系列を平滑化する。
func movingAverage(values []float64, window int) []float64 {
    if len(values) == 0 || window <= 1 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        start := index - half
        if start < 0 {
            start = 0
        }
        end := index + half
        if end >= len(values) {
            end = len(values) - 1
        }

        sum := 0.0
        count := 0
        for i := start; i <= end; i++ {
            sum += values[i]
            count++
        }

        result[index] = sum / float64(count)
    }

    return result
}

// savitzkyGolayCoefficients は Savitzky-Golay フィルターの係数を計算する。
// Gonumライブラリを使用して行列演算を効率的に行う。キャッシュ対応。
func savitzkyGolayCoefficients(window, order int) []float64 {
    if window%2 == 0 || order < 0 || order >= window {
        return nil
    }

    if _, ok := sgCache[window]; !ok {
        sgCache[window] = make(map[int][]float64)
    }
    if coeffs, ok := sgCache[window][order]; ok {
        return coeffs
    }

    half := window / 2
    n := window
    m := order

    // Vandermonde行列を作成
    A := mat.NewDense(n, m+1, nil)
    for i := 0; i < n; i++ {
        x := float64(i - half)
        for j := 0; j <= m; j++ {
            if j == 0 {
                A.Set(i, j, 1.0)
            } else {
                A.Set(i, j, A.At(i, j-1)*x)
            }
        }
    }

    // AtA = A^T * A を計算
    var At mat.Dense
    At.CloneFrom(A.T())
    var AtA mat.Dense
    AtA.Mul(&At, A)

    // AtAの逆行列を計算
    var AtAInv mat.Dense
    err := AtAInv.Inverse(&AtA)
    if err != nil {
        return nil // 特異行列の場合
    }

    // e_0 = [1, 0, 0, ...] を定義
    e0 := mat.NewVecDense(m+1, nil)
    e0.SetVec(0, 1.0)

    // c = (A^T A)^{-1} e_0 を計算
    var c mat.VecDense
    c.MulVec(&AtAInv, e0)

    // w = A * c を計算
    var w mat.VecDense
    w.MulVec(A, &c)

    // 結果をsliceに変換
    result := make([]float64, n)
    for i := 0; i < n; i++ {
        result[i] = w.AtVec(i)
    }

    sgCache[window][order] = result
    return result
}

// savitzkyGolay は Savitzky-Golay フィルターで標高系列を平滑化する。
func savitzkyGolay(values []float64, window, order int) []float64 {
    if len(values) == 0 || window <= 1 || order < 0 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    // windowを奇数にする
    if window%2 == 0 {
        window++
    }

    // orderがwindowより大きい場合は調整
    if order >= window {
        order = window - 1
    }

    // 係数を計算
    coeffs := savitzkyGolayCoefficients(window, order)
    if coeffs == nil {
        // 計算に失敗した場合は移動平均にフォールバック
        return movingAverage(values, window)
    }
    //log.Printf("Savitzky-Golay coefficients (window=%d, order=%d): %v", window, order, coeffs)

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        sum := 0.0
        for i := 0; i < window; i++ {
            srcIndex := index - half + i
            if srcIndex < 0 {
                srcIndex = 0
            } else if srcIndex >= len(values) {
                srcIndex = len(values) - 1
            }
            sum += values[srcIndex] * coeffs[i]
        }
        result[index] = sum
    }

    return result
}

// smoothValues は指定されたフィルタータイプで平滑化を行う。
func smoothValues(values []float64, filterType string, window, order int) []float64 {
    switch filterType {
    case "sg":
        return savitzkyGolay(values, window, order)
    case "ma":
        fallthrough
    default:
        return movingAverage(values, window)
    }
}

// getSmoothedAltitudes はactivityから平滑化標高系列を取得 (重複解消)
func getSmoothedAltitudes(activity *fit.ActivityFile, window int, filterType string, order int) []float64 {
    rawAltitudes := make([]float64, 0, len(activity.Records))
    for _, record := range activity.Records {
        if record.Altitude != 0xFFFF {
            rawAltitudes = append(rawAltitudes, float64(record.Altitude)/5.0-500.0)
        }
    }
    return smoothValues(rawAltitudes, filterType, window, order)
}

// (旧calculateGainFromSeries削除、常にヒステリシス使用)

// calculateGainWithHysteresis はヒステリシス付き区間ベースで上昇を検出して獲得標高を算出する。
// lastLow/lastHigh方式 (GPS標準準拠、最終区間/下降min対応)
func calculateGainWithHysteresis(altitudes []float64, ascThreshold, descThreshold float64) float64 {
    if len(altitudes) < 2 {
        return 0
    }

    if ascThreshold <= descThreshold || descThreshold <= 0 {
        return 0 // 不正な閾値
    }

    gain := 0.0
    state := "descending" // "ascending" or "descending"
    lastLow := altitudes[0]
    lastHigh := altitudes[0]

    for i := 1; i < len(altitudes); i++ {
        current := altitudes[i]
        if state == "descending" {
            if current > lastLow+ascThreshold {
                state = "ascending"
                lastHigh = current
            } else {
                lastLow = math.Min(lastLow, current) // 下降中最小値保持
            }
        } else { // ascending
            if current < lastHigh-descThreshold {
                gain += lastHigh - lastLow
                state = "descending"
                lastLow = current
            } else {
                lastHigh = math.Max(lastHigh, current)
            }
        }
    }

    // 最終区間がascendingの場合加算
    if state == "ascending" {
        gain += lastHigh - lastLow
    }

    return gain
}

// calculateElevationGainFromActivity は1つのActivityから獲得標高を計算または取得する。
func calculateElevationGainFromActivity(activity *fit.ActivityFile, forceCalc bool, window int, hystAsc, hystDesc float64, filterType string, order int) float64 {
    if !forceCalc {
        if len(activity.Sessions) > 0 {
            session := activity.Sessions[0]
            if session.TotalAscent != 0xFFFF {
                return float64(session.TotalAscent)
            }
        }
    }

    smoothedAltitudes := getSmoothedAltitudes(activity, window, filterType, order)
    return calculateGainWithHysteresis(smoothedAltitudes, hystAsc, hystDesc)
}

// calculateElevationGain はFITファイルを読み込み獲得標高を返す。
func calculateElevationGain(filePath string, forceCalc bool, window int, hystAsc, hystDesc float64, filterType string, order int) (float64, error) {
    file, err := os.Open(filePath)
    if err != nil {
        return 0, err
    }
    defer file.Close()

    // FITファイルをデコード
    fitFile, err := fit.Decode(file)
    if err != nil {
        return 0, err
    }

    // アクティビティデータを取得
    activity, err := fitFile.Activity()
    if err != nil {
        return 0, err
    }

    return calculateElevationGainFromActivity(activity, forceCalc, window, hystAsc, hystDesc, filterType, order), nil
}

// tuneParameters は指定ファイル群で最適なwindow/min-diff/orderを探索する。
func tuneParameters(files []string, windowMin, windowMax int, hystAscMin, hystAscMax, hystAscStep, hystDescMin, hystDescMax, hystDescStep float64, metric string, filterType string, orderMin, orderMax int) error {
    type sample struct {
        name         string
        activity     *fit.ActivityFile
        reference    float64
        rawAltitudes []float64
    }

    samples := make([]sample, 0, len(files))
    for _, filePath := range files {
        file, err := os.Open(filePath)
        if err != nil {
            return err
        }

        fitFile, err := fit.Decode(file)
        file.Close()
        if err != nil {
            return err
        }

        activity, err := fitFile.Activity()
        if err != nil {
            return err
        }

        if len(activity.Sessions) == 0 {
            continue
        }
        session := activity.Sessions[0]
        if session.TotalAscent == 0xFFFF {
            continue
        }

        rawAltitudes := make([]float64, 0, len(activity.Records))
        for _, record := range activity.Records {
            if record.Altitude != 0xFFFF {
                rawAltitudes = append(rawAltitudes, float64(record.Altitude)/5.0-500.0)
            }
        }

        samples = append(samples, sample{
            name:         filepath.Base(filePath),
            activity:     activity,
            reference:    float64(session.TotalAscent),
            rawAltitudes: rawAltitudes,
        })
    }

    if len(samples) == 0 {
        return fmt.Errorf("比較可能な Session.TotalAscent を持つファイルがありません")
    }

    if windowMin < 1 || windowMax < windowMin {
        return fmt.Errorf("不正な window 範囲: min=%d max=%d", windowMin, windowMax)
    }
    if hystAscMin < 0 || hystAscMax < hystAscMin || hystAscStep <= 0 {
        return fmt.Errorf("不正な hyst-asc 範囲: min=%.3f max=%.3f step=%.3f", hystAscMin, hystAscMax, hystAscStep)
    }
    if hystDescMin < 0 || hystDescMax < hystDescMin || hystDescStep <= 0 {
        return fmt.Errorf("不正な hyst-desc 範囲: min=%.3f max=%.3f step=%.3f", hystDescMin, hystDescMax, hystDescStep)
    }
    if metric != "mae" && metric != "rmse" {
        return fmt.Errorf("不正な metric: %s (mae または rmse を指定してください)", metric)
    }
    if filterType == "sg" {
        if orderMin < 1 || orderMax < orderMin {
            return fmt.Errorf("不正な order 範囲: min=%d max=%d", orderMin, orderMax)
        }
    }

    if windowMin%2 == 0 {
        windowMin++
    }
    if windowMax%2 == 0 {
        windowMax--
    }
    if windowMax < windowMin {
        return fmt.Errorf("window 範囲に奇数が含まれていません: min=%d max=%d", windowMin, windowMax)
    }

    bestWindow := 0
    bestHystAsc := 0.0
    bestHystDesc := 0.0
    bestOrder := orderMin
    bestScore := math.MaxFloat64

    if filterType == "sg" {
        // Savitzky-Golay: window, hyst-asc, hyst-desc, order の4次元探索
        for window := windowMin; window <= windowMax; window += 2 {
            for order := orderMin; order <= orderMax; order++ {
                if order >= window {
                    continue
                }
                for asc := hystAscMin; asc <= hystAscMax+1e-9; asc += hystAscStep {
                    for desc := hystDescMin; desc <= hystDescMax+1e-9; desc += hystDescStep {
                        if asc <= desc {
                            continue
                        }
                        totalAbsError := 0.0
                        totalSquaredError := 0.0
                        for _, sample := range samples {
                            smoothed := smoothValues(sample.rawAltitudes, filterType, window, order)
                            gain := calculateGainWithHysteresis(smoothed, asc, desc)
                            err := gain - sample.reference
                            totalAbsError += math.Abs(err)
                            totalSquaredError += err * err
                        }

                        score := 0.0
                        if metric == "rmse" {
                            score = math.Sqrt(totalSquaredError / float64(len(samples)))
                        } else {
                            score = totalAbsError / float64(len(samples))
                        }

                        if score < bestScore {
                            bestScore = score
                            bestWindow = window
                            bestHystAsc = asc
                            bestHystDesc = desc
                            bestOrder = order
                        }
                    }
                }
            }
        }
    } else {
        // 移動平均: window, hyst-asc, hyst-desc の3次元探索
        for window := windowMin; window <= windowMax; window += 2 {
            for asc := hystAscMin; asc <= hystAscMax+1e-9; asc += hystAscStep {
                for desc := hystDescMin; desc <= hystDescMax+1e-9; desc += hystDescStep {
                    if asc <= desc {
                        continue
                    }
                    totalAbsError := 0.0
                    totalSquaredError := 0.0
                    for _, sample := range samples {
                        smoothed := smoothValues(sample.rawAltitudes, filterType, window, orderMin)
                        gain := calculateGainWithHysteresis(smoothed, asc, desc)
                        err := gain - sample.reference
                        totalAbsError += math.Abs(err)
                        totalSquaredError += err * err
                    }

                    score := 0.0
                    if metric == "rmse" {
                        score = math.Sqrt(totalSquaredError / float64(len(samples)))
                    } else {
                        score = totalAbsError / float64(len(samples))
                    }

                    if score < bestScore {
                        bestScore = score
                        bestWindow = window
                        bestHystAsc = asc
                        bestHystDesc = desc
                    }
                }
            }
        }
    }

    fmt.Println("パラメータ探索結果 (--tune)")
    fmt.Println("==================================================")
    fmt.Printf("対象ファイル数: %d\n", len(samples))
    fmt.Printf("探索範囲: window=%d..%d (奇数), hyst-asc=%.2f..%.2f (step=%.2f), hyst-desc=%.2f..%.2f (step=%.2f)\n", windowMin, windowMax, hystAscMin, hystAscMax, hystAscStep, hystDescMin, hystDescMax, hystDescStep)
    fmt.Printf("フィルタータイプ: %s\n", filterType)
    if filterType == "sg" {
        fmt.Printf("多項式次数範囲: %d..%d\n", orderMin, orderMax)
    }
    fmt.Printf("評価指標: %s\n", strings.ToUpper(metric))
    fmt.Printf("最適 window: %d\n", bestWindow)
    fmt.Printf("最適 hyst-asc: %.2f\n", bestHystAsc)
    fmt.Printf("最適 hyst-desc: %.2f\n", bestHystDesc)
    if filterType == "sg" {
        fmt.Printf("最適 order: %d\n", bestOrder)
    }
    if metric == "rmse" {
        fmt.Printf("二乗平均平方根誤差(RMSE): %.2f m\n\n", bestScore)
    } else {
        fmt.Printf("平均絶対誤差(MAE): %.2f m\n\n", bestScore)
    }

    fmt.Println("ファイル別比較 (最適パラメータ適用)")
    fmt.Println("--------------------------------------------------")
    for _, sample := range samples {
        smoothed := smoothValues(sample.rawAltitudes, filterType, bestWindow, bestOrder)
        gain := calculateGainWithHysteresis(smoothed, bestHystAsc, bestHystDesc)
        diff := gain - sample.reference
        diffPercent := 0.0
        if sample.reference > 0 {
            diffPercent = diff / sample.reference * 100.0
        }
        fmt.Printf("%s: ref=%.0f, calc=%.2f, diff=%+.2f (%+.2f%%)\n", sample.name, sample.reference, gain, diff, diffPercent)
    }

    return nil
}

// main はCLI引数を解釈して獲得標高計算またはパラメータ探索を実行する。
func main() {
    fs := flag.NewFlagSet("elevationgain", flag.ContinueOnError)
    fs.Usage = printUsage

    // グローバルオプション
    forceCalc := fs.Bool("force-calc", false, "手動計算モード(Session.TotalAscent を無視)")
    shortForceCalc := fs.Bool("f", false, "force-calc の短形式")
    tuneMode := fs.Bool("tune", false, "パラメータ最適化モード")
    hystAsc := fs.Float64("hysteresis-asc", defaultHystAsc, "ヒステリシス上昇閾値 (m, 旧min-diff)")
    hystDesc := fs.Float64("hysteresis-desc", defaultHystDesc, "ヒステリシス下降閾値 (m)")
    window := fs.Int("window", movingAverageWindow, "窓幅(手動計算用)")
    metric := fs.String("metric", "mae", "評価指標: mae|rmse")
    filterType := fs.String("filter", defaultFilterType, "フィルタタイプ: ma|sg")
    order := fs.Int("order", defaultSGOrder, "多項式次数(--filter=sg 使用時)")
    exportCSV := fs.String("export-csv", "", "標高データをCSV出力 (1ファイル指定時のみ)")

    // Tune オプション(パラメータ探索用)
    tuneWindowMin := fs.Int("window-min", 3, "window 探索下限(奇数推奨)")
    tuneWindowMax := fs.Int("window-max", 21, "window 探索上限(奇数推奨)")
    tuneHystAscMin := fs.Float64("hyst-asc-min", 0.0, "hyst-asc 探索下限")
    tuneHystAscMax := fs.Float64("hyst-asc-max", 10.0, "hyst-asc 探索上限")
    tuneHystAscStep := fs.Float64("hyst-asc-step", 0.5, "hyst-asc 探索ステップ")
    tuneHystDescMin := fs.Float64("hyst-desc-min", 0.0, "hyst-desc 探索下限")
    tuneHystDescMax := fs.Float64("hyst-desc-max", 10.0, "hyst-desc 探索上限")
    tuneHystDescStep := fs.Float64("hyst-desc-step", 0.5, "hyst-desc 探索ステップ")
    tuneOrderMin := fs.Int("order-min", 1, "order 探索下限(--filter=sg --tune 使用時)")
    tuneOrderMax := fs.Int("order-max", 5, "order 探索上限(--filter=sg --tune 使用時)")
    // パース
    if err := fs.Parse(os.Args[1:]); err != nil {
        if err == flag.ErrHelp {
            os.Exit(0)
        }
        log.Fatalf("オプション解析エラー: %v", err)
    }

    // CSV出力モード
    if *exportCSV != "" {
        patterns := fs.Args()
        if len(patterns) != 1 {
            log.Fatalf("--export-csv は1ファイル指定時のみ利用可能です")
        }
        err := exportAltitudeCSV(patterns[0], *window, *filterType, *order, *exportCSV)
        if err != nil {
            log.Fatalf("CSV出力エラー: %v", err)
        }
        fmt.Printf("CSV出力完了: %s\n", *exportCSV)
        return
    }

    // -f と -force-calc のいずれかが指定されたか
    if *shortForceCalc {
        *forceCalc = true
    }

    // 非オプション引数(ファイルパターン)
    patterns := fs.Args()

    // 妥当性チェック
    if len(patterns) == 0 {
        printUsage()
        os.Exit(1)
    }

    if *hystAsc <= *hystDesc || *hystDesc <= 0 {
        log.Fatalf("不正なヒステリシス閾値: asc=%.3f, desc=%.3f (asc > desc > 0 を指定してください)", *hystAsc, *hystDesc)
    }

    if *window < 1 {
        log.Fatalf("不正な --window 値: %d (1以上の整数を指定してください)", *window)
    }
    if *order < 1 {
        log.Fatalf("不正な --order 値: %d (1以上の整数を指定してください)", *order)
    }
    if *metric != "mae" && *metric != "rmse" {
        log.Fatalf("不正な --metric 値: %s (mae または rmse を指定してください)", *metric)
    }
    if *filterType != "ma" && *filterType != "sg" {
        log.Fatalf("不正な --filter 値: %s (ma または sg を指定してください)", *filterType)
    }

    if *tuneWindowMin < 1 || *tuneWindowMax < *tuneWindowMin {
        log.Fatalf("不正な window 範囲: min=%d max=%d", *tuneWindowMin, *tuneWindowMax)
    }
    if *tuneHystAscMin < 0 || *tuneHystAscMax < *tuneHystAscMin || *tuneHystAscStep <= 0 {
        log.Fatalf("不正な hyst-asc 範囲: min=%.3f max=%.3f step=%.3f", *tuneHystAscMin, *tuneHystAscMax, *tuneHystAscStep)
    }
    if *tuneHystDescMin < 0 || *tuneHystDescMax < *tuneHystDescMin || *tuneHystDescStep <= 0 {
        log.Fatalf("不正な hyst-desc 範囲: min=%.3f max=%.3f step=%.3f", *tuneHystDescMin, *tuneHystDescMax, *tuneHystDescStep)
    }
    if *tuneOrderMin < 1 || *tuneOrderMax < *tuneOrderMin {
        log.Fatalf("不正な order 範囲: min=%d max=%d", *tuneOrderMin, *tuneOrderMax)
    }

    // ワイルドカード展開
    var files []string
    for _, pattern := range patterns {
        matches, err := filepath.Glob(pattern)
        if err != nil {
            log.Printf("警告: パターン '%s' の処理に失敗: %v", pattern, err)
            continue
        }
        if len(matches) == 0 {
            files = append(files, pattern)
        } else {
            files = append(files, matches...)
        }
    }

    if len(files) == 0 {
        log.Fatalf("処理するFITファイルが見つかりません")
    }

    if *tuneMode {
        err := tuneParameters(files, *tuneWindowMin, *tuneWindowMax, *tuneHystAscMin, *tuneHystAscMax, *tuneHystAscStep, *tuneHystDescMin, *tuneHystDescMax, *tuneHystDescStep, *metric, *filterType, *tuneOrderMin, *tuneOrderMax)
        if err != nil {
            log.Fatalf("パラメータ探索エラー: %v", err)
        }
        return
    }

    if *forceCalc {
        fmt.Printf("手動計算モード: filter=%s, window=%d, hysteresis-asc=%.2f, desc=%.2f", *filterType, *window, *hystAsc, *hystDesc)
        if *filterType == "sg" {
            fmt.Printf(", order=%d", *order)
        }
        fmt.Println()
    }

    fmt.Printf("FITファイルを解析中... (%d ファイル)\n\n", len(files))

    totalGain := 0.0
    successCount := 0

    // 各FITファイルを処理
    for _, file := range files {
        fileName := filepath.Base(file)
        gain, err := calculateElevationGain(file, *forceCalc, *window, *hystAsc, *hystDesc, *filterType, *order)
        if err != nil {
            fmt.Printf("❌ %s: エラー - %v\n", fileName, err)
            continue
        }

        fmt.Printf("✓ %s: %.2f m\n", fileName, gain)
        totalGain += gain
        successCount++
    }

    fmt.Printf("\n==================================================\n")
    fmt.Printf("処理ファイル数: %d / %d\n", successCount, len(files))
    fmt.Printf("合計獲得標高: %.2f m\n", totalGain)
    if successCount > 0 {
        fmt.Printf("平均獲得標高: %.2f m\n", totalGain/float64(successCount))
    }
}

// printUsage はヘルプメッセージを出力する。
func printUsage() {
    fmt.Fprintf(os.Stderr, `使用方法: elevationgain [オプション] <fitファイル1> [fitファイル2] ...

オプション:
  -force-calc
  手動計算モード(Session.TotalAscent を無視)
  -f
  force-calc の短形式
  -tune
  パラメータ最適化モード
  -hysteresis-asc float
  ヒステリシス上昇閾値 (m) (デフォルト: %.2f)
  -hysteresis-desc float
  ヒステリシス下降閾値 (m) (デフォルト: %.2f)
  -window int
  窓幅(手動計算用) (デフォルト: %d)
  -metric string
  評価指標: mae|rmse (デフォルト: mae)
  -filter string
  フィルタタイプ: ma|sg (デフォルト: %s)
  -order int
  多項式次数(--filter=sg 使用時) (デフォルト: %d)
  -export-csv string
  標高データをCSV出力 (1ファイル指定時のみ)
  -window-min int
  window 探索下限(奇数推奨) (デフォルト: 3)
  -window-max int
  window 探索上限(奇数推奨) (デフォルト: 21)
  -hyst-asc-min float
  hyst-asc 探索下限 (デフォルト: 0.00)
  -hyst-asc-max float
  hyst-asc 探索上限 (デフォルト: 10.00)
  -hyst-asc-step float
  hyst-asc 探索ステップ (デフォルト: 0.50)
  -hyst-desc-min float
  hyst-desc 探索下限 (デフォルト: 0.00)
  -hyst-desc-max float
  hyst-desc 探索上限 (デフォルト: 10.00)
  -hyst-desc-step float
  hyst-desc 探索ステップ (デフォルト: 0.50)
  -order-min int
  order 探索下限(--filter=sg --tune 使用時) (デフォルト: 1)
  -order-max int
  order 探索上限(--filter=sg --tune 使用時) (デフォルト: 5)

例:
  elevationgain Activities/251128104532.fit
  elevationgain --force-calc --window=11 --hysteresis-asc=0.15 Activities/*.fit
  elevationgain --hysteresis-asc=0.10 --hysteresis-desc=0.05 Activities/*.fit
  elevationgain --tune --filter=sg --order-min=1 --order-max=4 Activities/*.fit
  elevationgain --tune --metric=rmse --window-min=5 --window-max=25 --hyst-asc-min=0.0 --hyst-asc-max=0.5 Activities/*.fit
`, defaultHystAsc, defaultHystDesc, movingAverageWindow, defaultFilterType, defaultSGOrder)
}
go言語で挑戦:獲得標高とFITファイルの解析(2) Savitzky–Golay
Savitzky–Golay を使ってみる。
前回の記事 は、アクテビティのFITデータから1秒ごとの標高を取り出して獲得標高を計算しました。 1秒ごとの標高を移動平均でスムージングしてサイコンの獲得標高に近づけようと試みましたが、微妙に異なっていました。
移動平均の弱点は
ピークが丸まる(尖ったピークが必ず平らになる)
形状が失われる(山の形が “台形” から “丸い丘” に変わる)
ことです。
今回はSavitzky–Golay(サビツキーゴレイ)を使ってスムージングしたらどうなるかを実験してみます。
Savitzky–Golay と 移動平均 の特徴をまとめると以下の様になります。
| 問題 | 移動平均 | Savitzky–Golay(order=2) |
|---|---|---|
| ピーク保持 | × 丸まる | ○ 保持 |
| 形状保持 | × 丸くなる | ○ 放物線で保持 |
| ノイズ除去 | 強い | 強い+形状保持 |
Savitzky–Golay フィルタとは?
一言で言うと、「window 内のデータを多項式で近似し、その中心点の値を推定するフィルタ」です。
graph TD
  A[window 内のデータ点] --> B["多項式フィット<br>(直線/放物線/3曲線...)"]
  B --> C["中心点の値を最もよく推定する重み(係数)を計算"]
  C --> D["重み(係数)から中心点(平滑化された値)を計算"]
Savitzky–Golay フィルタは、window 内のデータを
order=1 → 直線
order=2 → 放物線
order=3 → 3次曲線
で近似し、その 中心点の値を最もよく推定するための重み(係数)を使って平滑化します。
Savitzky–Golay の係数は window と order だけで決まる
Savitzky–Golay の係数は データの値には依存しません。
window(例:21)
order(例:2)
この 2 つだけで 最適な重み(係数)が一意に決まります。
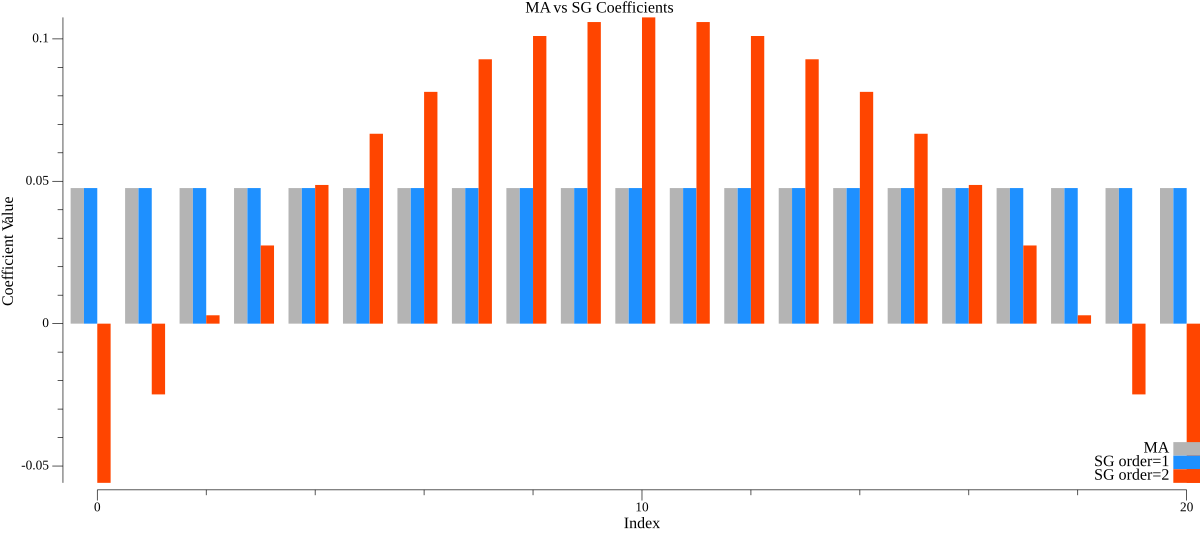
windows = 21 の order = 1, 2 の係数のグラフを以下に示します。青がorder=1 で移動平均(MA)と同じ係数となります。オレンジがorder=2 の係数です。中心を強調して、両端をノイズとしている様子がわかります。
係数を[w0,w1,...,w20]
window内の値を[x0,x1,...,x20]とすると
平滑化された値 = w0x0 + w1x1 + ... + w20*x20
となります。
Savitzky–Golay の実装
以下にSavitzky–Golay関連の核心部分の実装を記載します。(全コードは、記事の最後に記載)
1. savitzkyGolayCoefficients(係数計算関数)
// savitzkyGolayCoefficients は Savitzky-Golay 重み(係数)を計算する。
func savitzkyGolayCoefficients(window, order int) []float64 {
    if window%2 == 0 || order < 0 || order >= window {
        return nil
    }

    half := window / 2
    n := window
    m := order

    // Vandermonde行列を作成
    A := mat.NewDense(n, m+1, nil)
    for i := 0; i < n; i++ {
        x := float64(i - half)
        for j := 0; j <= m; j++ {
            if j == 0 {
                A.Set(i, j, 1.0)
            } else {
                A.Set(i, j, A.At(i, j-1)*x)
            }
        }
    }

    // AtA = A^T * A を計算
    var At mat.Dense
    At.CloneFrom(A.T())
    var AtA mat.Dense
    AtA.Mul(&At, A)

    // AtAの逆行列を計算
    var AtAInv mat.Dense
    err := AtAInv.Inverse(&AtA)
    if err != nil {
        return nil // 特異行列の場合
    }

    // e_0 = [1, 0, 0, ...] を定義
    e0 := mat.NewVecDense(m+1, nil)
    e0.SetVec(0, 1.0)

    // c = (A^T A)^{-1} e_0 を計算
    var c mat.VecDense
    c.MulVec(&AtAInv, e0)

    // w = A * c を計算
    var w mat.VecDense
    w.MulVec(A, &c)

    // 結果をsliceに変換
    result := make([]float64, n)
    for i := 0; i < n; i++ {
        result[i] = w.AtVec(i)
    }

    return result
}
2. savitzkyGolay(平滑化実行関数)
// savitzkyGolay は 重み(係数)で標高系列を平滑化する。
func savitzkyGolay(values []float64, window, order int) []float64 {
    if len(values) == 0 || window <= 1 || order < 0 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    // windowを奇数にする
    if window%2 == 0 {
        window++
    }

    // orderがwindowより大きい場合は調整
    if order >= window {
        order = window - 1
    }

    // 係数を計算
    coeffs := savitzkyGolayCoefficients(window, order)
    if coeffs == nil {
        // 計算に失敗した場合は移動平均にフォールバック
        return movingAverage(values, window)
    }
    //log.Printf("Savitzky-Golay coefficients (window=%d, order=%d): %v", window, order, coeffs)

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        sum := 0.0
        for i := 0; i < window; i++ {
            srcIndex := index - half + i
            if srcIndex < 0 {
                srcIndex = 0
            } else if srcIndex >= len(values) {
                srcIndex = len(values) - 1
            }
            sum += values[srcIndex] * coeffs[i]
        }
        result[index] = sum
    }

    return result
}
Savitzky–Golay 最適値を検索
自動探索モード(--tune)でwindow、orderと min-diff の最適値を既存FITファイルから推定できるようにしました。
min-diff は「前の点よりどれだけ上がったら上昇としてカウントするか」という閾値です。1秒ごとの標高差が min-diff 未満なら「ノイズ」とみなして無視するということです。
以下のコマンドで
Savitzky–Golay でスムージング (--filter=sg)
order を 1~2 で検索 (--order-min=1 --order-max=2)
window を 3~31 で検索 (--window-max=31)
Activitiesディレクトリ内のFITファイルを対象
として最適値を検索します。
go run main.go --tune --filter=sg --order-min=1 --order-max=2 --window-max=31 Activities/*.fit
結果は、以下の様にwindow = 21、order = 1、min-diff = 0.05 でした。 残念ながら、移動平均とまったく同じ効果しか得られませんでした。
考えられる原因は、
標高データはピークが少なく、Savitzky–Golay の強みが出ない
min-diff=0.05 が SG の形状保持効果を消してしまう
だと思います。
最適 window: 21
最適 min-diff: 0.05
最適 order: 1
平均絶対誤差(MAE): 23.65 m

ファイル別比較 (最適パラメータ適用)
--------------------------------------------------
251128104532.fit: ref=628, calc=642.35, diff=+14.35 (+2.29%)
251201074633.fit: ref=1442, calc=1399.86, diff=-42.14 (-2.92%)
251205095644.fit: ref=1056, calc=1036.90, diff=-19.10 (-1.81%)
251207101744.fit: ref=288, calc=279.16, diff=-8.84 (-3.07%)
251208101118.fit: ref=650, calc=623.70, diff=-26.30 (-4.05%)
251210095356.fit: ref=697, calc=669.71, diff=-27.29 (-3.91%)
251213100936.fit: ref=699, calc=670.07, diff=-28.93 (-4.14%)
251217075556.fit: ref=1506, calc=1449.29, diff=-56.71 (-3.77%)
251219102311.fit: ref=684, calc=673.11, diff=-10.89 (-1.59%)
251223111148.fit: ref=376, calc=387.39, diff=+11.39 (+3.03%)
251226095732.fit: ref=729, calc=717.90, diff=-11.10 (-1.52%)
251228063640.fit: ref=1138, calc=1138.13, diff=+0.13 (+0.01%)
251231095634.fit: ref=683, calc=665.03, diff=-17.97 (-2.63%)
260102085559.fit: ref=743, calc=725.94, diff=-17.06 (-2.30%)
260104110841.fit: ref=716, calc=732.35, diff=+16.35 (+2.28%)
260110110319.fit: ref=869, calc=852.54, diff=-16.46 (-1.89%)
260112090012.fit: ref=374, calc=407.70, diff=+33.70 (+9.01%)
260118061703.fit: ref=712, calc=740.88, diff=+28.88 (+4.06%)
260125062210.fit: ref=836, calc=902.75, diff=+66.75 (+7.98%)
260131092057.fit: ref=841, calc=829.22, diff=-11.78 (-1.40%)
260205062152.fit: ref=245, calc=233.36, diff=-11.64 (-4.75%)
260207053732.fit: ref=647, calc=639.53, diff=-7.47 (-1.15%)
260215063644.fit: ref=1460, calc=1421.43, diff=-38.57 (-2.64%)
260221070452.fit: ref=786, calc=810.26, diff=+24.26 (+3.09%)
260223080851.fit: ref=1309, calc=1272.30, diff=-36.70 (-2.80%)
全コード
package main

import (
    "flag"
    "fmt"
    "log"
    "math"
    "os"
    "path/filepath"
    "strings"

    "github.com/tormoder/fit"
    "gonum.org/v1/gonum/mat"
)

const (
    movingAverageWindow = 21 // 移動平均の窓幅(奇数推奨)
    minSmoothedDiff     = 0.2
    defaultFilterType   = "ma" // "ma" = moving average, "sg" = Savitzky-Golay
    defaultSGOrder      = 2    // Savitzky-Golay polynomial order
)

// movingAverage は指定窓幅で標高系列を平滑化する。
func movingAverage(values []float64, window int) []float64 {
    if len(values) == 0 || window <= 1 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        start := index - half
        if start < 0 {
            start = 0
        }
        end := index + half
        if end >= len(values) {
            end = len(values) - 1
        }

        sum := 0.0
        count := 0
        for i := start; i <= end; i++ {
            sum += values[i]
            count++
        }

        result[index] = sum / float64(count)
    }

    return result
}

// savitzkyGolayCoefficients は Savitzky-Golay フィルターの係数を計算する。
// Gonumライブラリを使用して行列演算を効率的に行う。
func savitzkyGolayCoefficients(window, order int) []float64 {
    if window%2 == 0 || order < 0 || order >= window {
        return nil
    }

    half := window / 2
    n := window
    m := order

    // Vandermonde行列を作成
    A := mat.NewDense(n, m+1, nil)
    for i := 0; i < n; i++ {
        x := float64(i - half)
        for j := 0; j <= m; j++ {
            if j == 0 {
                A.Set(i, j, 1.0)
            } else {
                A.Set(i, j, A.At(i, j-1)*x)
            }
        }
    }

    // AtA = A^T * A を計算
    var At mat.Dense
    At.CloneFrom(A.T())
    var AtA mat.Dense
    AtA.Mul(&At, A)

    // AtAの逆行列を計算
    var AtAInv mat.Dense
    err := AtAInv.Inverse(&AtA)
    if err != nil {
        return nil // 特異行列の場合
    }

    // e_0 = [1, 0, 0, ...] を定義
    e0 := mat.NewVecDense(m+1, nil)
    e0.SetVec(0, 1.0)

    // c = (A^T A)^{-1} e_0 を計算
    var c mat.VecDense
    c.MulVec(&AtAInv, e0)

    // w = A * c を計算
    var w mat.VecDense
    w.MulVec(A, &c)

    // 結果をsliceに変換
    result := make([]float64, n)
    for i := 0; i < n; i++ {
        result[i] = w.AtVec(i)
    }

    return result
}

// savitzkyGolay は Savitzky-Golay フィルターで標高系列を平滑化する。
func savitzkyGolay(values []float64, window, order int) []float64 {
    if len(values) == 0 || window <= 1 || order < 0 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    // windowを奇数にする
    if window%2 == 0 {
        window++
    }

    // orderがwindowより大きい場合は調整
    if order >= window {
        order = window - 1
    }

    // 係数を計算
    coeffs := savitzkyGolayCoefficients(window, order)
    if coeffs == nil {
        // 計算に失敗した場合は移動平均にフォールバック
        return movingAverage(values, window)
    }
    //log.Printf("Savitzky-Golay coefficients (window=%d, order=%d): %v", window, order, coeffs)

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        sum := 0.0
        for i := 0; i < window; i++ {
            srcIndex := index - half + i
            if srcIndex < 0 {
                srcIndex = 0
            } else if srcIndex >= len(values) {
                srcIndex = len(values) - 1
            }
            sum += values[srcIndex] * coeffs[i]
        }
        result[index] = sum
    }

    return result
}

// smoothValues は指定されたフィルタータイプで平滑化を行う。
func smoothValues(values []float64, filterType string, window, order int) []float64 {
    switch filterType {
    case "sg":
        return savitzkyGolay(values, window, order)
    case "ma":
        fallthrough
    default:
        return movingAverage(values, window)
    }
}

// calculateGainFromSeries は上昇差分のみを合算して獲得標高を算出する。
func calculateGainFromSeries(altitudes []float64, minDiff float64) float64 {
    if len(altitudes) < 2 {
        return 0
    }

    gain := 0.0
    previous := altitudes[0]
    for _, altitude := range altitudes[1:] {
        if altitude > previous {
            diff := altitude - previous
            if diff >= minDiff {
                gain += diff
            }
        }
        previous = altitude
    }

    return gain
}

// calculateElevationGainFromActivity は1つのActivityから獲得標高を計算または取得する。
func calculateElevationGainFromActivity(activity *fit.ActivityFile, forceCalc bool, window int, minDiff float64, filterType string, order int) float64 {
    if !forceCalc {
        if len(activity.Sessions) > 0 {
            session := activity.Sessions[0]
            if session.TotalAscent != 0xFFFF {
                return float64(session.TotalAscent)
            }
        }
    }

    rawAltitudes := make([]float64, 0, len(activity.Records))
    for _, record := range activity.Records {
        if record.Altitude != 0xFFFF {
            rawAltitudes = append(rawAltitudes, float64(record.Altitude)/5.0-500.0)
        }
    }

    smoothedAltitudes := smoothValues(rawAltitudes, filterType, window, order)
    return calculateGainFromSeries(smoothedAltitudes, minDiff)
}

// calculateElevationGain はFITファイルを読み込み獲得標高を返す。
func calculateElevationGain(filePath string, forceCalc bool, window int, minDiff float64, filterType string, order int) (float64, error) {
    file, err := os.Open(filePath)
    if err != nil {
        return 0, err
    }
    defer file.Close()

    // FITファイルをデコード
    fitFile, err := fit.Decode(file)
    if err != nil {
        return 0, err
    }

    // アクティビティデータを取得
    activity, err := fitFile.Activity()
    if err != nil {
        return 0, err
    }

    return calculateElevationGainFromActivity(activity, forceCalc, window, minDiff, filterType, order), nil
}

// tuneParameters は指定ファイル群で最適なwindow/min-diff/orderを探索する。
func tuneParameters(files []string, windowMin int, windowMax int, diffMin float64, diffMax float64, diffStep float64, metric string, filterType string, orderMin int, orderMax int) error {
    type sample struct {
        name      string
        activity  *fit.ActivityFile
        reference float64
    }

    samples := make([]sample, 0, len(files))
    for _, filePath := range files {
        file, err := os.Open(filePath)
        if err != nil {
            return err
        }

        fitFile, err := fit.Decode(file)
        file.Close()
        if err != nil {
            return err
        }

        activity, err := fitFile.Activity()
        if err != nil {
            return err
        }

        if len(activity.Sessions) == 0 {
            continue
        }
        session := activity.Sessions[0]
        if session.TotalAscent == 0xFFFF {
            continue
        }

        samples = append(samples, sample{
            name:      filepath.Base(filePath),
            activity:  activity,
            reference: float64(session.TotalAscent),
        })
    }

    if len(samples) == 0 {
        return fmt.Errorf("比較可能な Session.TotalAscent を持つファイルがありません")
    }

    if windowMin < 1 || windowMax < windowMin {
        return fmt.Errorf("不正な window 範囲: min=%d max=%d", windowMin, windowMax)
    }
    if diffMin < 0 || diffMax < diffMin || diffStep <= 0 {
        return fmt.Errorf("不正な min-diff 範囲: min=%.3f max=%.3f step=%.3f", diffMin, diffMax, diffStep)
    }
    if metric != "mae" && metric != "rmse" {
        return fmt.Errorf("不正な metric: %s (mae または rmse を指定してください)", metric)
    }
    if filterType == "sg" {
        if orderMin < 1 || orderMax < orderMin {
            return fmt.Errorf("不正な order 範囲: min=%d max=%d", orderMin, orderMax)
        }
    }

    if windowMin%2 == 0 {
        windowMin++
    }
    if windowMax%2 == 0 {
        windowMax--
    }
    if windowMax < windowMin {
        return fmt.Errorf("window 範囲に奇数が含まれていません: min=%d max=%d", windowMin, windowMax)
    }

    bestWindow := 0
    bestMinDiff := 0.0
    bestOrder := orderMin
    bestScore := math.MaxFloat64

    if filterType == "sg" {
        // Savitzky-Golay: window, min-diff, order の3次元探索
        for window := windowMin; window <= windowMax; window += 2 {
            for order := orderMin; order <= orderMax; order++ {
                // order は window より小さくなければならない
                if order >= window {
                    continue
                }
                for minDiff := diffMin; minDiff <= diffMax+1e-9; minDiff += diffStep {
                    totalAbsError := 0.0
                    totalSquaredError := 0.0
                    for _, sample := range samples {
                        gain := calculateElevationGainFromActivity(sample.activity, true, window, minDiff, filterType, order)
                        err := gain - sample.reference
                        totalAbsError += math.Abs(err)
                        totalSquaredError += err * err
                    }

                    score := 0.0
                    if metric == "rmse" {
                        score = math.Sqrt(totalSquaredError / float64(len(samples)))
                    } else {
                        score = totalAbsError / float64(len(samples))
                    }

                    if score < bestScore {
                        bestScore = score
                        bestWindow = window
                        bestMinDiff = minDiff
                        bestOrder = order
                    }
                }
            }
        }
    } else {
        // 移動平均: window, min-diff の2次元探索
        for window := windowMin; window <= windowMax; window += 2 {
            for minDiff := diffMin; minDiff <= diffMax+1e-9; minDiff += diffStep {
                totalAbsError := 0.0
                totalSquaredError := 0.0
                for _, sample := range samples {
                    gain := calculateElevationGainFromActivity(sample.activity, true, window, minDiff, filterType, orderMin)
                    err := gain - sample.reference
                    totalAbsError += math.Abs(err)
                    totalSquaredError += err * err
                }

                score := 0.0
                if metric == "rmse" {
                    score = math.Sqrt(totalSquaredError / float64(len(samples)))
                } else {
                    score = totalAbsError / float64(len(samples))
                }

                if score < bestScore {
                    bestScore = score
                    bestWindow = window
                    bestMinDiff = minDiff
                }
            }
        }
    }

    fmt.Println("パラメータ探索結果 (--tune)")
    fmt.Println("==================================================")
    fmt.Printf("対象ファイル数: %d\n", len(samples))
    fmt.Printf("探索範囲: window=%d..%d (奇数), min-diff=%.2f..%.2f (step=%.2f)\n", windowMin, windowMax, diffMin, diffMax, diffStep)
    fmt.Printf("フィルタータイプ: %s\n", filterType)
    if filterType == "sg" {
        fmt.Printf("多項式次数範囲: %d..%d\n", orderMin, orderMax)
    }
    fmt.Printf("評価指標: %s\n", strings.ToUpper(metric))
    fmt.Printf("最適 window: %d\n", bestWindow)
    fmt.Printf("最適 min-diff: %.2f\n", bestMinDiff)
    if filterType == "sg" {
        fmt.Printf("最適 order: %d\n", bestOrder)
    }
    if metric == "rmse" {
        fmt.Printf("二乗平均平方根誤差(RMSE): %.2f m\n\n", bestScore)
    } else {
        fmt.Printf("平均絶対誤差(MAE): %.2f m\n\n", bestScore)
    }

    fmt.Println("ファイル別比較 (最適パラメータ適用)")
    fmt.Println("--------------------------------------------------")
    for _, sample := range samples {
        gain := calculateElevationGainFromActivity(sample.activity, true, bestWindow, bestMinDiff, filterType, bestOrder)
        diff := gain - sample.reference
        diffPercent := 0.0
        if sample.reference > 0 {
            diffPercent = diff / sample.reference * 100.0
        }
        fmt.Printf("%s: ref=%.0f, calc=%.2f, diff=%+.2f (%+.2f%%)\n", sample.name, sample.reference, gain, diff, diffPercent)
    }

    return nil
}

// main はCLI引数を解釈して獲得標高計算またはパラメータ探索を実行する。
func main() {
    fs := flag.NewFlagSet("elevationgain", flag.ContinueOnError)
    fs.Usage = printUsage

    // グローバルオプション
    forceCalc := fs.Bool("force-calc", false, "手動計算モード(Session.TotalAscent を無視)")
    shortForceCalc := fs.Bool("f", false, "force-calc の短形式")
    tuneMode := fs.Bool("tune", false, "パラメータ最適化モード")
    window := fs.Int("window", movingAverageWindow, "窓幅(手動計算用)")
    minDiff := fs.Float64("min-diff", minSmoothedDiff, "最小標高差(手動計算用)")
    metric := fs.String("metric", "mae", "評価指標: mae|rmse")
    filterType := fs.String("filter", defaultFilterType, "フィルタタイプ: ma|sg")
    order := fs.Int("order", defaultSGOrder, "多項式次数(--filter=sg 使用時)")

    // Tune オプション(パラメータ探索用)
    tuneWindowMin := fs.Int("window-min", 3, "window 探索下限(奇数推奨)")
    tuneWindowMax := fs.Int("window-max", 21, "window 探索上限(奇数推奨)")
    tuneDiffMin := fs.Float64("diff-min", 0.0, "min-diff 探索下限")
    tuneDiffMax := fs.Float64("diff-max", 1.0, "min-diff 探索上限")
    tuneDiffStep := fs.Float64("diff-step", 0.05, "min-diff 探索ステップ")
    tuneOrderMin := fs.Int("order-min", 1, "order 探索下限(--filter=sg --tune 使用時)")
    tuneOrderMax := fs.Int("order-max", 5, "order 探索上限(--filter=sg --tune 使用時)")

    // パース
    if err := fs.Parse(os.Args[1:]); err != nil {
        if err == flag.ErrHelp {
            os.Exit(0)
        }
        log.Fatalf("オプション解析エラー: %v", err)
    }

    // -f と -force-calc のいずれかが指定されたか
    if *shortForceCalc {
        *forceCalc = true
    }

    // 非オプション引数(ファイルパターン)
    patterns := fs.Args()

    // -f の場合は --force-calc として処理
    if len(os.Args) > 1 && os.Args[1] == "-f" {
        *forceCalc = true
    }

    // 妥当性チェック
    if len(patterns) == 0 {
        printUsage()
        os.Exit(1)
    }

    if *window < 1 {
        log.Fatalf("不正な --window 値: %d (1以上の整数を指定してください)", *window)
    }
    if *minDiff < 0 {
        log.Fatalf("不正な --min-diff 値: %.3f (0以上の数値を指定してください)", *minDiff)
    }
    if *order < 1 {
        log.Fatalf("不正な --order 値: %d (1以上の整数を指定してください)", *order)
    }
    if *metric != "mae" && *metric != "rmse" {
        log.Fatalf("不正な --metric 値: %s (mae または rmse を指定してください)", *metric)
    }
    if *filterType != "ma" && *filterType != "sg" {
        log.Fatalf("不正な --filter 値: %s (ma または sg を指定してください)", *filterType)
    }

    if *tuneWindowMin < 1 || *tuneWindowMax < *tuneWindowMin {
        log.Fatalf("不正な window 範囲: min=%d max=%d", *tuneWindowMin, *tuneWindowMax)
    }
    if *tuneDiffMin < 0 || *tuneDiffMax < *tuneDiffMin || *tuneDiffStep <= 0 {
        log.Fatalf("不正な min-diff 範囲: min=%.3f max=%.3f step=%.3f", *tuneDiffMin, *tuneDiffMax, *tuneDiffStep)
    }
    if *tuneOrderMin < 1 || *tuneOrderMax < *tuneOrderMin {
        log.Fatalf("不正な order 範囲: min=%d max=%d", *tuneOrderMin, *tuneOrderMax)
    }

    // ワイルドカード展開
    var files []string
    for _, pattern := range patterns {
        matches, err := filepath.Glob(pattern)
        if err != nil {
            log.Printf("警告: パターン '%s' の処理に失敗: %v", pattern, err)
            continue
        }
        if len(matches) == 0 {
            files = append(files, pattern)
        } else {
            files = append(files, matches...)
        }
    }

    if len(files) == 0 {
        log.Fatalf("処理するFITファイルが見つかりません")
    }

    if *tuneMode {
        err := tuneParameters(files, *tuneWindowMin, *tuneWindowMax, *tuneDiffMin, *tuneDiffMax, *tuneDiffStep, *metric, *filterType, *tuneOrderMin, *tuneOrderMax)
        if err != nil {
            log.Fatalf("パラメータ探索エラー: %v", err)
        }
        return
    }

    if *forceCalc {
        fmt.Printf("手動計算モード: filter=%s, window=%d, min-diff=%.2f", *filterType, *window, *minDiff)
        if *filterType == "sg" {
            fmt.Printf(", order=%d", *order)
        }
        fmt.Println()
    }

    fmt.Printf("FITファイルを解析中... (%d ファイル)\n\n", len(files))

    totalGain := 0.0
    successCount := 0

    // 各FITファイルを処理
    for _, file := range files {
        fileName := filepath.Base(file)
        gain, err := calculateElevationGain(file, *forceCalc, *window, *minDiff, *filterType, *order)
        if err != nil {
            fmt.Printf("❌ %s: エラー - %v\n", fileName, err)
            continue
        }

        fmt.Printf("✓ %s: %.2f m\n", fileName, gain)
        totalGain += gain
        successCount++
    }

    fmt.Printf("\n==================================================\n")
    fmt.Printf("処理ファイル数: %d / %d\n", successCount, len(files))
    fmt.Printf("合計獲得標高: %.2f m\n", totalGain)
    if successCount > 0 {
        fmt.Printf("平均獲得標高: %.2f m\n", totalGain/float64(successCount))
    }
}

// printUsage はヘルプメッセージを出力する。
func printUsage() {
    fmt.Fprintf(os.Stderr, `使用方法: elevationgain [オプション] <fitファイル1> [fitファイル2] ...

オプション:
  -force-calc
  手動計算モード(Session.TotalAscent を無視)
  -f
  force-calc の短形式
  -tune
  パラメータ最適化モード
  -window int
  窓幅(手動計算用) (デフォルト: %d)
  -min-diff float
  最小標高差(手動計算用) (デフォルト: %.2f)
  -metric string
  評価指標: mae|rmse (デフォルト: mae)
  -filter string
  フィルタタイプ: ma|sg (デフォルト: %s)
  -order int
  多項式次数(--filter=sg 使用時) (デフォルト: %d)
  -window-min int
  window 探索下限(奇数推奨) (デフォルト: 3)
  -window-max int
  window 探索上限(奇数推奨) (デフォルト: 21)
  -diff-min float
  min-diff 探索下限 (デフォルト: 0.00)
  -diff-max float
  min-diff 探索上限 (デフォルト: 1.00)
  -diff-step float
  min-diff 探索ステップ (デフォルト: 0.05)
  -order-min int
  order 探索下限(--filter=sg --tune 使用時) (デフォルト: 1)
  -order-max int
  order 探索上限(--filter=sg --tune 使用時) (デフォルト: 5)

例:
  elevationgain Activities/251128104532.fit
  elevationgain --force-calc --window=11 --min-diff=0.15 Activities/*.fit
  elevationgain --tune --filter=sg --order-min=1 --order-max=4 Activities/*.fit
  elevationgain --tune --metric=rmse --window-min=5 --window-max=25 Activities/*.fit
`, movingAverageWindow, minSmoothedDiff, defaultFilterType, defaultSGOrder)
}
次回
go言語で挑戦:獲得標高とFITファイルの解析 (1)
獲得標高って何だろう?
獲得標高(Elevation Gain)とは、サイクリング(ロードバイク)で、スタートからゴールまでに上った高度の合計(累積上昇標高)です。下りは計算に含めず、アップダウンの「登り」のみを積算します。 GPSサイクルコンピューター(以降は、サイコン)や、Stravaなどの走行記録アプリで計算されます。サイコンが内部でどのように獲得標高を計算しているかは、公式には公開されていません。
「どういうアルゴリズムで計算しているのだろう?」と気になってしまいました。最近、golangを覚えたのでgoで実装実験します。まあ、LLMに書かせるだけですけどね。。。
FITファイルとは?
サイコンで走行ログや活動データ(GPS、心拍数、ケイデンス、パワーなど)を保存するバイナリファイル形式です。以下のような感じの走行ログが格納されています。Webサービス(Bryton Active、Strava)にアップロードして可視化、共有します。
| timestamp(s) | position lat(deg) | position long(deg) | altitude |
|---|---|---|---|
| 09:59:25 | 35.501168 | 139.435301 | 2850 |
| 09:59:26 | 35.501161 | 139.435241 | 2555 |
altitude(標高)は、以下のような仕様で格納されています。
Garmin FIT SDK(FIT Protocol仕様)
| Field Name | Type | Units | Scale | Offset |
|---|---|---|---|---|
| altitude | uint16 | m | 5 | 500 |
このデータは、0.2m単位で-500mから約13107.0mまでの範囲を表すことができます。
- uint16型の範囲は 0 から 65535
- スケール値「5」で割ると、1単位は 1 ÷ 5 = 0.2m
- 最小値は 0 ÷ 5 - 500 = -500m
- 最大値は (65535 ÷ 5) - 500 = 13107.0m
したがって以下でメートルに補正する必要があります。
altitude = altitude / 5 - 500
実装
移動平均/スムージング
走行ログのデータを眺めてみると、1秒ごとに記録されていてかなりセンシティブな感じなので
altitude(標高) → 移動平均スムージング → 上昇量積算
というアルゴリズムにします。
移動平均のwindow と min-diffはパラメータとします。
min-diff は「前の点よりどれだけ上がったら上昇としてカウントするか」という閾値です。1秒ごとの標高差が min-diff 未満なら「ノイズ」とみなして無視するということです。
自動探索モード(--tune)を追加して、window と min-diff の最適値を既存FITファイルから推定できるようにします。
package main

import (
    "fmt"
    "log"
    "math"
    "os"
    "path/filepath"
    "strconv"
    "strings"

    "github.com/tormoder/fit"
)

const (
    movingAverageWindow = 21
    minSmoothedDiff     = 0.05
)

// movingAverage は指定窓幅で標高系列を平滑化する。
func movingAverage(values []float64, window int) []float64 {
    if len(values) == 0 || window <= 1 {
        copied := make([]float64, len(values))
        copy(copied, values)
        return copied
    }

    result := make([]float64, len(values))
    half := window / 2

    for index := range values {
        start := index - half
        if start < 0 {
            start = 0
        }
        end := index + half
        if end >= len(values) {
            end = len(values) - 1
        }

        sum := 0.0
        count := 0
        for i := start; i <= end; i++ {
            sum += values[i]
            count++
        }

        result[index] = sum / float64(count)
    }

    return result
}
// calculateGainFromSeries は上昇差分のみを合算して獲得標高を算出する。
func calculateGainFromSeries(altitudes []float64, minDiff float64) float64 {
    if len(altitudes) < 2 {
        return 0
    }

    gain := 0.0
    previous := altitudes[0]
    for _, altitude := range altitudes[1:] {
        if altitude > previous {
            diff := altitude - previous
            if diff >= minDiff {
                gain += diff
            }
        }
        previous = altitude
    }

    return gain
}
// calculateElevationGainFromActivity は1つのActivityから獲得標高を計算または取得する。
func calculateElevationGainFromActivity(activity *fit.ActivityFile, forceCalc bool, window int, minDiff float64) float64 {
    if !forceCalc {
        if len(activity.Sessions) > 0 {
            session := activity.Sessions[0]
            if session.TotalAscent != 0xFFFF {
                return float64(session.TotalAscent)
            }
        }
    }

    rawAltitudes := make([]float64, 0, len(activity.Records))
    for _, record := range activity.Records {
        if record.Altitude != 0xFFFF {
            rawAltitudes = append(rawAltitudes, float64(record.Altitude)/5.0-500.0)
        }
    }

    smoothedAltitudes := movingAverage(rawAltitudes, window)
    return calculateGainFromSeries(smoothedAltitudes, minDiff)
}
// calculateElevationGain はFITファイルを読み込み獲得標高を返す。
func calculateElevationGain(filePath string, forceCalc bool, window int, minDiff float64) (float64, error) {
    file, err := os.Open(filePath)
    if err != nil {
        return 0, err
    }
    defer file.Close()

    // FITファイルをデコード
    fitFile, err := fit.Decode(file)
    if err != nil {
        return 0, err
    }

    // アクティビティデータを取得
    activity, err := fitFile.Activity()
    if err != nil {
        return 0, err
    }

    return calculateElevationGainFromActivity(activity, forceCalc, window, minDiff), nil
}
// tuneParameters は指定ファイル群で最適なwindow/min-diffを探索する。
func tuneParameters(files []string, windowMin int, windowMax int, diffMin float64, diffMax float64, diffStep float64, metric string) error {
    type sample struct {
        name      string
        activity  *fit.ActivityFile
        reference float64
    }

    samples := make([]sample, 0, len(files))
    for _, filePath := range files {
        file, err := os.Open(filePath)
        if err != nil {
            return err
        }

        fitFile, err := fit.Decode(file)
        file.Close()
        if err != nil {
            return err
        }

        activity, err := fitFile.Activity()
        if err != nil {
            return err
        }

        if len(activity.Sessions) == 0 {
            continue
        }
        session := activity.Sessions[0]
        if session.TotalAscent == 0xFFFF {
            continue
        }

        samples = append(samples, sample{
            name:      filepath.Base(filePath),
            activity:  activity,
            reference: float64(session.TotalAscent),
        })
    }

    if len(samples) == 0 {
        return fmt.Errorf("比較可能な Session.TotalAscent を持つファイルがありません")
    }

    if windowMin < 1 || windowMax < windowMin {
        return fmt.Errorf("不正な window 範囲: min=%d max=%d", windowMin, windowMax)
    }
    if diffMin < 0 || diffMax < diffMin || diffStep <= 0 {
        return fmt.Errorf("不正な min-diff 範囲: min=%.3f max=%.3f step=%.3f", diffMin, diffMax, diffStep)
    }
    if metric != "mae" && metric != "rmse" {
        return fmt.Errorf("不正な metric: %s (mae または rmse を指定してください)", metric)
    }

    if windowMin%2 == 0 {
        windowMin++
    }
    if windowMax%2 == 0 {
        windowMax--
    }
    if windowMax < windowMin {
        return fmt.Errorf("window 範囲に奇数が含まれていません: min=%d max=%d", windowMin, windowMax)
    }

    bestWindow := 0
    bestMinDiff := 0.0
    bestScore := math.MaxFloat64

    for window := windowMin; window <= windowMax; window += 2 {
        for minDiff := diffMin; minDiff <= diffMax+1e-9; minDiff += diffStep {
            totalAbsError := 0.0
            totalSquaredError := 0.0
            for _, sample := range samples {
                gain := calculateElevationGainFromActivity(sample.activity, true, window, minDiff)
                err := gain - sample.reference
                totalAbsError += math.Abs(err)
                totalSquaredError += err * err
            }

            score := 0.0
            if metric == "rmse" {
                score = math.Sqrt(totalSquaredError / float64(len(samples)))
            } else {
                score = totalAbsError / float64(len(samples))
            }

            if score < bestScore {
                bestScore = score
                bestWindow = window
                bestMinDiff = minDiff
            }
        }
    }

    fmt.Println("パラメータ探索結果 (--tune)")
    fmt.Println("==================================================")
    fmt.Printf("対象ファイル数: %d\n", len(samples))
    fmt.Printf("探索範囲: window=%d..%d (奇数), min-diff=%.2f..%.2f (step=%.2f)\n", windowMin, windowMax, diffMin, diffMax, diffStep)
    fmt.Printf("評価指標: %s\n", strings.ToUpper(metric))
    fmt.Printf("最適 window: %d\n", bestWindow)
    fmt.Printf("最適 min-diff: %.2f\n", bestMinDiff)
    if metric == "rmse" {
        fmt.Printf("二乗平均平方根誤差(RMSE): %.2f m\n\n", bestScore)
    } else {
        fmt.Printf("平均絶対誤差(MAE): %.2f m\n\n", bestScore)
    }

    fmt.Println("ファイル別比較 (最適パラメータ適用)")
    fmt.Println("--------------------------------------------------")
    for _, sample := range samples {
        gain := calculateElevationGainFromActivity(sample.activity, true, bestWindow, bestMinDiff)
        diff := gain - sample.reference
        diffPercent := 0.0
        if sample.reference > 0 {
            diffPercent = diff / sample.reference * 100.0
        }
        fmt.Printf("%s: ref=%.0f, calc=%.2f, diff=%+.2f (%+.2f%%)\n", sample.name, sample.reference, gain, diff, diffPercent)
    }

    return nil
}
// main はCLI引数を解釈して獲得標高計算またはパラメータ探索を実行する。
func main() {
    // コマンドライン引数からファイルパスを取得
    args := os.Args[1:]
    forceCalc := false
    tuneMode := false
    window := movingAverageWindow
    minDiff := minSmoothedDiff
    metric := "mae"
    tuneWindowMin := 3
    tuneWindowMax := 21
    tuneDiffMin := 0.0
    tuneDiffMax := 1.0
    tuneDiffStep := 0.05

    var patterns []string
    for _, arg := range args {
        switch {
        case arg == "--force-calc" || arg == "-f":
            forceCalc = true
        case arg == "--tune":
            tuneMode = true
        case strings.HasPrefix(arg, "--window="):
            value := strings.TrimPrefix(arg, "--window=")
            parsed, err := strconv.Atoi(value)
            if err != nil || parsed < 1 {
                log.Fatalf("不正な --window 値: %s (1以上の整数を指定してください)", value)
            }
            window = parsed
        case strings.HasPrefix(arg, "--min-diff="):
            value := strings.TrimPrefix(arg, "--min-diff=")
            parsed, err := strconv.ParseFloat(value, 64)
            if err != nil || parsed < 0 {
                log.Fatalf("不正な --min-diff 値: %s (0以上の数値を指定してください)", value)
            }
            minDiff = parsed
        case strings.HasPrefix(arg, "--window-min="):
            value := strings.TrimPrefix(arg, "--window-min=")
            parsed, err := strconv.Atoi(value)
            if err != nil || parsed < 1 {
                log.Fatalf("不正な --window-min 値: %s (1以上の整数を指定してください)", value)
            }
            tuneWindowMin = parsed
        case strings.HasPrefix(arg, "--window-max="):
            value := strings.TrimPrefix(arg, "--window-max=")
            parsed, err := strconv.Atoi(value)
            if err != nil || parsed < 1 {
                log.Fatalf("不正な --window-max 値: %s (1以上の整数を指定してください)", value)
            }
            tuneWindowMax = parsed
        case strings.HasPrefix(arg, "--diff-min="):
            value := strings.TrimPrefix(arg, "--diff-min=")
            parsed, err := strconv.ParseFloat(value, 64)
            if err != nil || parsed < 0 {
                log.Fatalf("不正な --diff-min 値: %s (0以上の数値を指定してください)", value)
            }
            tuneDiffMin = parsed
        case strings.HasPrefix(arg, "--diff-max="):
            value := strings.TrimPrefix(arg, "--diff-max=")
            parsed, err := strconv.ParseFloat(value, 64)
            if err != nil || parsed < 0 {
                log.Fatalf("不正な --diff-max 値: %s (0以上の数値を指定してください)", value)
            }
            tuneDiffMax = parsed
        case strings.HasPrefix(arg, "--diff-step="):
            value := strings.TrimPrefix(arg, "--diff-step=")
            parsed, err := strconv.ParseFloat(value, 64)
            if err != nil || parsed <= 0 {
                log.Fatalf("不正な --diff-step 値: %s (0より大きい数値を指定してください)", value)
            }
            tuneDiffStep = parsed
        case strings.HasPrefix(arg, "--metric="):
            value := strings.ToLower(strings.TrimPrefix(arg, "--metric="))
            if value != "mae" && value != "rmse" {
                log.Fatalf("不正な --metric 値: %s (mae または rmse を指定してください)", value)
            }
            metric = value
        default:
            patterns = append(patterns, arg)
        }
    }

    if len(patterns) == 0 {
        fmt.Println("使用方法: go run main.go [--force-calc|-f] [--tune] <fitファイル1> [fitファイル2] ...")
        fmt.Println("オプション: --window=<整数> --min-diff=<数値> --tune --metric=mae|rmse")
        fmt.Println("tune範囲: --window-min=<整数> --window-max=<整数> --diff-min=<数値> --diff-max=<数値> --diff-step=<数値>")
        fmt.Println("例: go run main.go Activities/251128104532.fit Activities/251201074633.fit")
        fmt.Println("例: go run main.go --force-calc Activities/*.fit")
        fmt.Println("例: go run main.go --force-calc --window=11 --min-diff=0.15 Activities/*.fit")
        fmt.Println("例: go run main.go --tune --metric=mae Activities/*.fit")
        fmt.Println("例: go run main.go --tune --metric=rmse --window-min=5 --window-max=25 --diff-min=0.00 --diff-max=0.80 --diff-step=0.02 Activities/*.fit")
        fmt.Println("または: go run main.go Activities/*.fit")
        os.Exit(1)
    }

    // 指定されたファイルを展開(ワイルドカード対応)
    var files []string
    for _, pattern := range patterns {
        matches, err := filepath.Glob(pattern)
        if err != nil {
            log.Printf("警告: パターン '%s' の処理に失敗: %v", pattern, err)
            continue
        }
        if len(matches) == 0 {
            // ワイルドカードがない場合はそのまま追加
            files = append(files, pattern)
        } else {
            files = append(files, matches...)
        }
    }

    if len(files) == 0 {
        log.Fatalf("処理するFITファイルが見つかりません")
    }

    if tuneMode {
        err := tuneParameters(files, tuneWindowMin, tuneWindowMax, tuneDiffMin, tuneDiffMax, tuneDiffStep, metric)
        if err != nil {
            log.Fatalf("パラメータ探索エラー: %v", err)
        }
        return
    }

    if forceCalc {
        fmt.Printf("手動計算モード: window=%d, min-diff=%.2f\n", window, minDiff)
    }

    fmt.Printf("FITファイルを解析中... (%d ファイル)\n\n", len(files))

    totalGain := 0.0
    successCount := 0

    // 各FITファイルを処理
    for _, file := range files {
        fileName := filepath.Base(file)
        gain, err := calculateElevationGain(file, forceCalc, window, minDiff)
        if err != nil {
            fmt.Printf("❌ %s: エラー - %v\n", fileName, err)
            continue
        }

        fmt.Printf("✓ %s: %.2f m\n", fileName, gain)
        totalGain += gain
        successCount++
    }

    fmt.Printf("\n==================================================\n")
    fmt.Printf("処理ファイル数: %d / %d\n", successCount, len(files))
    fmt.Printf("合計獲得標高: %.2f m\n", totalGain)
    if successCount > 0 {
        fmt.Printf("平均獲得標高: %.2f m\n", totalGain/float64(successCount))
    }
}
結果は以下の様になりました。
- ref はサイコンが計算した獲得標高
- calc は本アルゴリズムが計算した獲得標高
パラメータ探索結果 (--tune)
==================================================
対象ファイル数: 26
探索範囲: window=3..21 (奇数), min-diff=0.00..1.00 (step=0.05)
評価指標: MAE
最適 window: 21
最適 min-diff: 0.05
平均絶対誤差(MAE): 23.67 m

ファイル別比較 (最適パラメータ適用)
--------------------------------------------------
251128104532.fit: ref=628, calc=642.15, diff=+14.15 (+2.25%)
251201074633.fit: ref=1442, calc=1399.80, diff=-42.20 (-2.93%)
251205095644.fit: ref=1056, calc=1036.90, diff=-19.10 (-1.81%)
251207101744.fit: ref=288, calc=279.16, diff=-8.84 (-3.07%)
251208101118.fit: ref=650, calc=623.66, diff=-26.34 (-4.05%)
251210095356.fit: ref=697, calc=669.71, diff=-27.29 (-3.91%)
251213100936.fit: ref=699, calc=670.07, diff=-28.93 (-4.14%)
251217075556.fit: ref=1506, calc=1449.29, diff=-56.71 (-3.77%)
251219102311.fit: ref=684, calc=673.06, diff=-10.94 (-1.60%)
251223111148.fit: ref=376, calc=387.38, diff=+11.38 (+3.03%)
251226095732.fit: ref=729, calc=717.72, diff=-11.28 (-1.55%)
251228063640.fit: ref=1138, calc=1137.88, diff=-0.12 (-0.01%)
251231095634.fit: ref=683, calc=664.97, diff=-18.03 (-2.64%)
260102085559.fit: ref=743, calc=725.58, diff=-17.42 (-2.34%)
260104110841.fit: ref=716, calc=732.44, diff=+16.44 (+2.30%)
260110110319.fit: ref=869, calc=853.02, diff=-15.98 (-1.84%)
260112090012.fit: ref=374, calc=407.70, diff=+33.70 (+9.01%)
260118061703.fit: ref=712, calc=740.88, diff=+28.88 (+4.06%)
260125062210.fit: ref=836, calc=902.75, diff=+66.75 (+7.98%)
260131092057.fit: ref=841, calc=828.82, diff=-12.18 (-1.45%)
260205062152.fit: ref=245, calc=233.36, diff=-11.64 (-4.75%)
260207053732.fit: ref=647, calc=639.36, diff=-7.64 (-1.18%)
260215063644.fit: ref=1460, calc=1421.43, diff=-38.57 (-2.64%)
260221070452.fit: ref=786, calc=810.26, diff=+24.26 (+3.09%)
260223080851.fit: ref=1309, calc=1272.51, diff=-36.49 (-2.79%)
まとめ
本記事では、サイクリングにおける獲得標高の定義、FIT ファイルのデータ構造、 Go 言語による計算アルゴリズムの実装までを解説しました。標高データがノイズを多く含むため、移動平均スムージング・min-diff といったパラメータが必要になる背景を、具体的なコードとともに紹介しました。
さらに、実際の FIT ファイルを用いてパラメータチューニングを行い、 サイコンが出力する 獲得標高との誤差を評価しました。その結果、平均絶対誤差(MAE)は約 23.67m とまあまあな精度を達成できることが確認できました。
次回は、Savitzky–Golay でスムージングしてみます。
Strava MCP Server でアクテビティ分析
はじめに
MCP(Model Context Protocol)が流行っているようです。私も何か役立ちそうな実装をしてみようと思いました。
そこで「Strava APIをLLMからAPIを呼び出すStrava MCP Server を作ろう」とパッと思いつきました。
GitHubを検索するとStrava MCP Serverのpython実装はけっこうあります。みんな、思いつくことは一緒ですね。
本記事では、代表的な実装をVS Code + Cline でセットアップ、実行した結果を紹介します。
GitHubにはいろいろpython実装があるのですが、以下のレポジトリを利用します。
理由:
- 以下の説明が気に入りました。
Model Context Protocol server for Strava API. I couldn't find any others that actually worked, so I rolled my own.
実装がきれい(私の好み)
初めて、Strava MCP Serverを使うときに、Stravaの認証が行われる(他の多くの実装は事前に認証が必要)
Cline のセットアップ
モデル:x-ai/grok-code-fast-1 (Context: 256K) freeなので...
Cline -> MCP Servers -> Configure -> Configure MCP Servers で以下を指定します。
{
  "mcpServers": {
    "strava": {
      "command": "あなたのPython(例 C:\\Users\\hoge\\tmp\\strava-mcp\\.venv\\Scripts\\python.exe)",
      "args": [
        "-m",
        "strava_mcp"
      ],
      "env": {
        "STRAVA_CLIENT_ID": "あなたのSTRAVA_CLIENT_ID",
        "STRAVA_CLIENT_SECRET": "あなたのSTRAVA_CLIENT_SECRET"
      }
    }
  }
}
使ってみる
その1(獲得標高、心拍数から負荷傾向を分析)
get_recent_activities を使って
以下のライドの獲得標高、心拍数から負荷傾向を分析してください。
2025/10
2025/11
2025/12
## 月別ライドアクティビティ分析(2025年)

### 2025年12月

- __ライド回数__: 4回
- __総距離__: 226.8 km
- __平均獲得標高__: 1,144.5 m/回
- __平均心拍数__: 128.0 bpm
- __主な特徴__: 長距離ライドが中心で、獲得標高が非常に高い(最大1,506m)。心拍数は安定して高め。

### 2025年11月

- __ライド回数__: 7回
- __総距離__: 370.2 km
- __平均獲得標高__: 720.1 m/回
- __平均心拍数__: 125.5 bpm
- __主な特徴__: 12月より頻度が高く、獲得標高も安定。心拍数は12月より若干低い。

### 2025年10月

- __ライド回数__: 3回
- __総距離__: 171.6 km
- __平均獲得標高__: 905.0 m/回
- __平均心拍数__: 129.7 bpm
- __主な特徴__: 獲得標高が高めだが、回数が少ない。心拍数は最も高い。

## 負荷傾向分析

### 獲得標高の傾向

- __12月 > 10月 > 11月__: 12月の平均獲得標高が最も高く(1,144m)、11月が最も低い(720m)
- __全体として高い負荷__: 全期間を通じて獲得標高が700m以上と高負荷が継続
- __12月の突出__: 12月は特に厳しい山岳コースでのトレーニングが目立つ

### 心拍数の傾向

- __10月 > 12月 > 11月__: 10月の平均心拍数が最も高く(130bpm)、11月が最も低い(126bpm)
- __安定した有酸素負荷__: 全期間を通じて心拍数が125-130bpmで安定推移
- __11月の回復傾向__: 心拍数が最も低く、獲得標高も抑えめで回復期を示唆

### 全体的な負荷パターン

1. __10月__: 高強度スタート - 心拍数高め、獲得標高も高い
2. __11月__: 安定期 - 頻度増加、心拍数やや低下で適度な負荷維持
3. __12月__: 高負荷期 - 獲得標高大幅増加でピーク負荷

__総評__: 全体として高いトレーニング負荷を維持しつつ、11月を回復期として12月にピーク負荷をかける戦略的なトレーニングパターンを示しています。獲得標高の変動が大きく、心拍数も安定した有酸素トレーニングが継続されています。
その2(特定アクテビティの心拍ゾーン分析)
直近アクテビティの心拍ゾーンを分析して
直近アクティビティ(朝のランニング)の心拍数ストリームを分析して、心拍数ゾーンごとの時間を計算しました。

__心拍数ゾーン定義 (最大心拍数149 BPM基準):__

- Zone 1 (回復): 74-89 BPM (50-60%)
- Zone 2 (脂肪燃焼): 89-104 BPM (60-70%)
- Zone 3 (有酸素): 104-119 BPM (70-80%)
- Zone 4 (嫌気性): 119-134 BPM (80-90%)
- Zone 5 (最大努力): 134-149 BPM (90-100%)

__心拍数ゾーン分析結果:__

| ゾーン | BPM範囲 | データポイント数 | 時間(秒) | 時間(分) | 割合 | |--------|---------|------------------|----------|----------|------| | Zone 1 | 74-89 | 1,647 | 1,647 | 27.5 | 32.5% | | Zone 2 | 89-104 | 1,422 | 1,422 | 23.7 | 28.1% | | Zone 3 | 104-119 | 1,135 | 1,135 | 18.9 | 22.4% | | Zone 4 | 119-134 | 614 | 614 | 10.2 | 12.1% | | Zone 5 | 134-149 | 258 | 258 | 4.3 | 5.1% |

__分析の考察:__

- __Zone 1と2の時間が長い__: 60.6%の時間が低強度ゾーンで過ごされており、長時間の持続的なペースでのランニングだったことがわかります
- __Zone 3の適度な活用__: 有酸素ゾーンが22.4%を占めており、一定のトレーニング効果が期待できます
- __高強度ゾーンの少なさ__: Zone 4と5合わせて17.2%と少なく、回復重視のセッションだったと考えられます
- __全体の安定性__: 心拍数が比較的安定しており、一定ペースでのランニングが維持できていたことを示しています

この分析から、今回のランニングは持久力向上を目的としたロングペースのトレーニングとして適切だったと考えられます。
その3(特定アクテビティの心拍ゾーン分析:NG)
直近のライドアクテビティの心拍ゾーンを分析して
残念ながら、以下のエラーとなりました。 原因は、心拍数ストリームデータ(1秒ごとの心拍数)が多すぎるためです。
[CLINE] stream_initialization_failedFailed to create stream: inference request failed: failed to invoke model 'xai/grok-code-fast-1' with streaming from Vercel: request failed with status 400: {"error":{"message":"Bad Request","type":"AI_APICallError","param":{"error":"Bad Request","statusCode":400,"name":"AI_APICallError","message":"Bad Request","url":"https://api.x.ai/v1/chat/completions","isRetryable":false,"type":"AI_APICallError"}}}
Request ID: sUJlyfeJeBkSypvZemdWfPmkeUkLaOOn
{"message":"Failed to create stream: inference request failed: failed to invoke model 'xai/grok-code-fast-1' with streaming from Vercel: request failed with status 400: {\"error\":{\"message\":\"Bad Request\",\"type\":\"AI_APICallError\",\"param\":{\"error\":\"Bad Request\",\"statusCode\":400,\"name\":\"AI_APICallError\",\"message\":\"Bad Request\",\"url\":\"https://api.x.ai/v1/chat/completions\",\"isRetryable\":false,\"type\":\"AI_APICallError\"}}}","request_id":"sUJlyfeJeBkSypvZemdWfPmkeUkLaOOn","code":"stream_initialization_failed","modelId":"x-ai/grok-code-fast-1","providerId":"cline","details":{"code":"stream_initialization_failed","message":"Failed to create stream: inference request failed: failed to invoke model 'xai/grok-code-fast-1' with streaming from Vercel: request failed with status 400: {\"error\":{\"message\":\"Bad Request\",\"type\":\"AI_APICallError\",\"param\":{\"error\":\"Bad Request\",\"statusCode\":400,\"name\":\"AI_APICallError\",\"message\":\"Bad Request\",\"url\":\"https://api.x.ai/v1/chat/completions\",\"isRetryable\":false,\"type\":\"AI_APICallError\"}}}","request_id":"sUJlyfeJeBkSypvZemdWfPmkeUkLaOOn","type":"stream_error"}}
まとめ
利用した実装では、Strava APIを単純に中継しているためデータ数が大量になり、トークン数が多く破綻する可能性がある。
以下のデータは適切に間引く必要があります。
- 心拍数、ケイデンス、パワーなどのストリームデータ
- 位置情報
とは言え、基本的には利用できそうです。気が向いたら、修正していこうと思います。
AIエージェントと作る「Agentic RAG」完全ガイド|LangGraph × Pinecone で賢いRAGを構築する方法
目次
はじめに
この記事のコード
Agentic Ragとは
全体アーキテクチャ
LangGraphによるエージェントフロー
データの前準備
質問応答CLIの例
まとめ
実は(私はほぼ一切コードを書いていません)
コード抜粋
UnitTestもClineに実行させる
はじめに
最近話題の Agentic RAG を、実際に自分でも作ってみました。
といっても、自分で書いたわけではありません。 今回のコード、AI(cline + tngtech/deepseek-r1t2-chimera:free)に作らせました。 私はほぼ一切コードを書いていません。
本記事では、このプロセスで作った LangChain + LangGraph + Pinecone + Web 検索(Tavily) を使った Agentic RAG の構成や仕組みを、初心者にもわかりやすく紹介します。
この記事のコード
この記事のコードは以下にあります。是非、遊んでみて下さい。 https://github.com/atsushi3hsgw/agentic_rag_sample
Agentic RAGとは
RAG(Retrieval-Augmented Generation)に “意思決定” を与えたものです。
通常のRAGは:
質問を受け取る
ベクタDBから関連ドキュメントを取る
回答する
という直線的なフロー。
Agentic RAGは違います。
連文書の質が低い → Web検索へ切り替える
質問が検索向けではない → LLMでリライト
文書が不十分 → 再検索
ソースの整合性をチェック
ステータス管理しながら動作
つまり 「状況に応じて動く」 賢い RAG です。
今回の実装は LangGraph を使って、この「判断と遷移」を綺麗に表現しました。
全体アーキテクチャ
| 使用技術 | 役割 | 技術 |
|---|---|---|
| LLM | OpenRouter 経由 tngtech/deepseek-r1t2-chimera:free | |
| ベクタDB | Pinecone | |
| Embedding | text-embedding-3-small | |
| Web検索 | Tavily | |
| フロー制御 | LangGraph | |
| CLI | Python |
OpenRouterに10ドル以上クレジットすれば無料でレート制限なしでtngtech/deepseek-r1t2-chimera:freeなどのfree版LLMが使えます。
LangGraphによるエージェントフロー
この RAG の内部では、LangGraph を使って次のような状態遷移を構築しています。
graph TD;
        __start__([<p>__start__</p>]):::first
        retrieve(retrieve)
        evaluate_docs(evaluate_docs)
        should_web_search(should_web_search)
        optimize_query(optimize_query)
        web_search(web_search)
        generate_answer(generate_answer)
        __end__([<p>__end__</p>]):::last
        __start__ --> retrieve;
        evaluate_docs --> should_web_search;
        optimize_query --> web_search;
        retrieve --> evaluate_docs;
        should_web_search -.-> generate_answer;
        should_web_search -.-> optimize_query;
        web_search --> generate_answer;
        generate_answer --> __end__;
        classDef default fill-opacity:0,line-height:1.2
        classDef first fill-opacity:0
        classDef last fill-opacity:0
retrieve:Pinecone から文書を取ってくる
evaluate_docs:LLMが文書の関連性を YES/NO 判定
should_web_search:
すべてYES → Web検索不要
NOがある or 文書がない → Web検索する
optimize_query(Web検索が必要な場合)
LLMで「検索に最適なクエリ」にリライト
web_search:Tavily API で上位の検索結果を取得
generate_answer
Pinecone文書+Web結果から回答を生成 (不適切と判定された文書は除外)
データの前準備
CLI load2vector_cli.py を作っており、
python load2vector_cli.py dataset.jsonl
で以下を実行します。
JSONL を読み込み
RecursiveCharacterTextSplitter で分割
OpenAI Embedding でベクトル化
Pinecone index(自動生成)へ保存
質問応答CLIの例
python agentic_rag_cli.py "GPU の仕組みを教えて"
ベクタDBの文章を評価
必要なら Web 検索
すべて統合した回答を生成
ベクタDBの文章だけで回答でききるケースの例
python src/cmd/agentic_rag_cli.py "沖縄の温泉でおすすめは?"
2025-12-04 17:23:41,838 - INFO - Initializing AgenticRAG system
2025-12-04 17:23:44,160 - INFO - Processing question: 沖縄の温泉でおすすめは?
2025-12-04 17:23:46,641 - AgenticRAG - INFO - Retrieved 5 documents
2025-12-04 17:23:46,642 - AgenticRAG - INFO - [1/5] Score: 0.6069, Title: 中乃湯温泉
Preview: 中乃湯(なかのゆ)は沖縄県沖縄市にある温泉公衆浴場。 県内に現存する唯一の「ゆーふるやー(湯風呂屋)」である。  番台はあるが使用されておらず、入浴料は店主を見つけて直接支払う。 脱衣所と浴室の仕切り...
2025-12-04 17:23:46,642 - AgenticRAG - INFO - [2/5] Score: 0.5782, Title: 山田温泉 (沖縄県)
Preview: 山田温泉(やまだおんせん)は、沖縄県国頭郡恩納村にある温泉。  含硫黄ナトリウム塩化物炭酸水素温泉(硫化水素 型) 源泉温度 - 23.4℃(浴用に加熱) 湧出量 - 毎分1,500ml  『ルネッサン...
2025-12-04 17:23:46,643 - AgenticRAG - INFO - [3/5] Score: 0.5531, Title: 宮古島温泉
Preview: 宮古島温泉(みやこじまおんせん)は、沖縄県宮古島市にある温泉。現在は休業中。  ナトリウム-塩化物泉 源泉温度52℃  2006年12月に温泉施設がオープンし、2010年4月現在ゲストハウスも併設して...
2025-12-04 17:23:46,643 - AgenticRAG - INFO - [4/5] Score: 0.5419, Title: ちゃたん恵み温泉
Preview: ちゃたん恵み温泉(ちゃたんめぐみおんせん)は、沖縄県北谷町美浜の北谷町運動公園内にある温泉。別名、美浜の湯 (みはまのゆ)。共立メンテナンスが運営するTerme VILLA ちゅらーゆという日帰り入浴施...
2025-12-04 17:23:46,643 - AgenticRAG - INFO - [5/5] Score: 0.5300, Title: 西表島温泉
Preview: 西表島温泉(いりおもてじまおんせん)は、かつて西表島北東部の沖縄県八重山郡竹富町高那にあった温泉である。西 表温泉と呼ばれることもあった。  日本最西端かつ最南端の温泉で、リゾートホテル西表島ジャングル...
2025-12-04 17:24:45,266 - AgenticRAG - INFO - Document Evaluation: 5/5 documents relevant
2025-12-04 17:24:45,267 - AgenticRAG - INFO - [1/5] Score: 0.6069, Title: 中乃湯温泉
Preview: 中乃湯(なかのゆ)は沖縄県沖縄市にある温泉公衆浴場。 県内に現存する唯一の「ゆーふるやー(湯風呂屋)」である。  番台はあるが使用されておらず、入浴料は店主を見つけて直接支払う。 脱衣所と浴室の仕切り...
2025-12-04 17:24:45,267 - AgenticRAG - INFO - [2/5] Score: 0.5782, Title: 山田温泉 (沖縄県)
Preview: 山田温泉(やまだおんせん)は、沖縄県国頭郡恩納村にある温泉。  含硫黄ナトリウム塩化物炭酸水素温泉(硫化水素 型) 源泉温度 - 23.4℃(浴用に加熱) 湧出量 - 毎分1,500ml  『ルネッサン...
2025-12-04 17:24:45,267 - AgenticRAG - INFO - [3/5] Score: 0.5531, Title: 宮古島温泉
Preview: 宮古島温泉(みやこじまおんせん)は、沖縄県宮古島市にある温泉。現在は休業中。  ナトリウム-塩化物泉 源泉温度52℃  2006年12月に温泉施設がオープンし、2010年4月現在ゲストハウスも併設して...
2025-12-04 17:24:45,267 - AgenticRAG - INFO - [4/5] Score: 0.5419, Title: ちゃたん恵み温泉
Preview: ちゃたん恵み温泉(ちゃたんめぐみおんせん)は、沖縄県北谷町美浜の北谷町運動公園内にある温泉。別名、美浜の湯 (みはまのゆ)。共立メンテナンスが運営するTerme VILLA ちゅらーゆという日帰り入浴施...
2025-12-04 17:24:45,267 - AgenticRAG - INFO - [5/5] Score: 0.5300, Title: 西表島温泉
Preview: 西表島温泉(いりおもてじまおんせん)は、かつて西表島北東部の沖縄県八重山郡竹富町高那にあった温泉である。西 表温泉と呼ばれることもあった。  日本最西端かつ最南端の温泉で、リゾートホテル西表島ジャングル...

Answer:
文脈情報に基づく沖縄の温泉のおすすめは以下の通りです。各施設の特徴を詳しくご紹介します:

### 1. **中乃湯(沖縄市)**
- **唯一無二の伝統体験**
  沖縄県内で現存する唯一の「ゆーふるやー(湯風呂屋)」で、昭和レトロな雰囲気が特徴。脱衣所と浴室の仕切りがなく、鍵なしロッカーなど簡素な造りが昔ながらの銭湯文化を体感できます。
- **泉質**:弱アルカリ性ナトリウム-炭酸水素塩・塩化物泉(源泉は無色透明ですが、入浴剤で緑色に着色)。
- **注意点**
  - 石鹸・シャンプーなし(持参必須)
  - 混合栓ではなく単水栓のため湯加減調整が難しい
  - 汲み取り式トイレ
- **利用料金**:店主に直接支払う方式(金額は文脈に記載なし)
- **おすすめポイント**:地元住民との交流や素朴な雰囲気を求める方に。
...
Web検索して回答でききるケースの例
python src/cmd/agentic_rag_cli.py "GPU の仕組みを教えて"
2025-12-04 20:26:17,765 - INFO - Initializing AgenticRAG system
2025-12-04 20:26:20,007 - INFO - Processing question: GPU の仕組みを教えて
2025-12-04 20:26:26,365 - AgenticRAG - INFO - Retrieved 1 documents
2025-12-04 20:26:26,365 - AgenticRAG - INFO - [1/1] Score: 0.3094, Title: JR東日本209系電車
Preview: 車両本体の製造工法の見直しと新機軸の試用 車両や機材製造企業の選定にコンペ方式を導入 新しい車体構造の開発 台車の取り付け位置 を中央寄りに詰めるともに両端のドアの下にかからないように設計することで、車...
2025-12-04 20:26:47,273 - AgenticRAG - INFO - Document Evaluation: 0/1 documents relevant
2025-12-04 20:27:05,526 - AgenticRAG - INFO - Query Optimization:
Original: GPU の仕組みを教えて
Optimized: 「GPUの基本構造と並列処理の仕組みをわかりやすく解説 グラフィックス処理や機械学習での動作原理とは?」
2025-12-04 20:27:05,526 - AgenticRAG - INFO - Web Search : Query: 「GPUの基本構造と並列処理の仕組みをわかりやすく解説 グラフィックス 処理や機械学習での動作原理とは?」
2025-12-04 20:27:07,219 - AgenticRAG - INFO - Web Search: Retrieved 5 results
2025-12-04 20:27:07,220 - AgenticRAG - INFO - [1/5] Title: GPUとは?その種類や特徴、活用分野をわかりやすく解説!
URL: https://www.ai-souken.com/article/what-is-gpu
2025-12-04 20:27:07,220 - AgenticRAG - INFO - [2/5] Title: GPUとは何かわかりやすく解説|CPUとの違いや活用事例について ...
URL: https://biz.kddi.com/content/column/smartwork/what-is-gpu/
2025-12-04 20:27:07,221 - AgenticRAG - INFO - [3/5] Title: 基礎からわかるGPU 性能・特徴や選び方のポイント
URL: https://www.ntt.com/business/services/rink/knowledge/archive_13.html
2025-12-04 20:27:07,221 - AgenticRAG - INFO - [4/5] Title: GPGPUとは?初心者でもわかる並列計算技術の基礎知識
URL: https://www.blooktecpc-support.com/useful/what_is_gpgpu/
2025-12-04 20:27:07,221 - AgenticRAG - INFO - [5/5] Title: GPUがどう動くのか説明してくれませんか? : r/buildapc - Reddit
URL: https://www.reddit.com/r/buildapc/comments/17ovqau/could_you_explain_me_how_gpus_work/?tl=ja
2025-12-04 20:27:09,046 - INFO - HTTP Request: POST https://openrouter.ai/api/v1/chat/completions "HTTP/1.1 200 OK"

Answer:
GPU(Graphics Processing Unit)は、**並列処理に特化したプロセッサ**であり、以下のような仕組みで動作します:

### 1. **並列処理アーキテクチャ**
- **数千の小さなコア**を搭載し、単純な計算を同時に実行できます。
- CPUが「複雑な処理を順次実行」するのに対し、GPUは「単純な処理を大量に並列処理」します。
- 例:ゲームの1フレーム描画時、画面の全ピクセル計算を数千コアで分担処理。

...
まとめ
文書評価を LLM が行う → 精度が上がる
必要に応じて Web検索へ自動遷移
LangGraph でフローが透明化
Pinecone・Tavily と相性が良い構成
AI サイドで “状況判断” ができるため、RAGが賢くなる
実は
実はこの Agentic RAG、 私はほぼ一切コードを書いていません。
使ったのは VS Code + Cline(AIエージェント) + OpenRouter + tngtech/deepseek-r1t2-chimera:free
なぜ、この組み合わせかというと「OpenRouterに10ドル以上クレジットすればレート制限なしで最新のfree版LLMが使えるからです。
私は最初に仕様を与えただけ。
そこから:
AI がコード生成
実行してエラー検出
自律的に修正案を提示
私が承認
再実行
また修正
再実行…
という 共同開発スタイル でした。
最初に与えた指示は以下です。生成できたら、コードを確認して仕様を追加、修正を指示、いけてないコードを生成したら、人間が修正案を指示する。これを繰り返しました。それでも、人間が作るより早いです。
繰り返しが多く発生してしまったのは、「私の設計不足に大きな原因 」があります。
【最初に与えた指示】
以下の仕様でAgentic Rag クラスを作って下さい。
- ファイル:src/rag/agentic_rag.py
- langchain
- langgraph を使ってステータスを管理して必要な処理に遷移する
- langchain,langgraphは、最新の安定バージョンを使う
- ベクタデータベースはpinecone
- LLM:openrouter経由でx-ai/grok-4.1-fast:free、パラメータで指定可能
- 埋め込み:openrouter経由でopenai/text-embedding-3-small、パラメータで指定可能

- 処理概要を示す
- ベクタデータベースから与えられた質問と関連する文章を検索する.
    - 指定したスコア(score)以上の文章を指定した数(k)だけ検索する.
    - スコア(score)はコサイン類似度.
    - 文章とメタ情報を取得する.
    - メタ情報は、 タイトル(title)、ID(article_id)、スコア(score)がある.
        - タイトル(title)、ID(article_id)は、ベクタデータベースに保存されている.
        - スコア(score)は、計算結果のコサイン類似度.

- 検索した文書が与えられた質問に関連しているかどうかを評価する.
    - LLMを使用する。回答は「YES」または「NO」のいずれか.
    - プロンプトの例
        system:
            あなたは、検索された文書がユーザーの質問に関連しているかどうかを評価する専門の評価者です。
            評価を行う際は、以下の指示に従ってください:
                文書に質問に関連するキーワードまたは意味が含まれている場合、関連性があると評価してください。
                評価は「YES」または「NO」のいずれかで、文書が質問に関連しているかどうかを示してください。
        human:
            取得した文書
                {document}
            与えられた質問:
                {question}

- Web検索が必要か判定する.
    - 検索した文書が与えられた質問に関連しているかどうかを評価する.
    - 評価の結果、少なくとも1つの文書が文脈的に関連していない場合、または文脈文書がまったく検索されなかった場合は、「Web検索が必要」と判断する.
- Web検索が必要の場合
    - LLMを用いて、与えられた質問をウェブ検索向けに最適化されたより良い表現にする.
        - プロンプトの例
            system:
                質問の再構成者として以下のタスクを実行してください:
                    以下の入力質問を、ウェブ検索向けに最適化されたより良いバージョンに変換する
                    入力質問を分析し、その背後にある意味的意図/意味を推論する
            human:
                入力質問:
                    {question}
                改善された質問を作成してください
    - ウェブ検索にTavily APIを使用する.
        - 検索では、上位wk件の検索結果を取得する.

- 与えられた質問に答える
    - ベクタデータベースから取得した文章、ウェブ検索で取得した文章を使って与えられた質問に答える
        - 評価結果が「NO」の文章は含めない
    - プロンプト例
        system:
            あなたは質問応答タスクのアシスタントです。
            質問に答えるために、取得した以下の文脈情報を使用してください。
            文脈情報が存在しない場合、または答えがわからない場合は、答えがわからないと伝えてください。
            提供された文脈にない限り、答えをでっち上げないでください。
            質問に対して詳細かつ的を射た回答を提供してください。
        user:
            質問:
            {question}
            文脈:
            {context}
            回答:
コード抜粋
agentic_rag.py
from typing import TypedDict, List, Dict, Any, Optional
from urllib.parse import unquote
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_pinecone import PineconeVectorStore
from langchain_core.documents import Document
from pydantic import BaseModel, Field
from pinecone import Pinecone
from tavily import TavilyClient
from langchain_core.output_parsers import StrOutputParser
import logging
from langgraph.graph import StateGraph, END

# Prompt constants from specification (in Japanese as provided)
EVAL_SYSTEM = """
あなたは、検索された文書が与えられた質問に関連しているかどうかを評価する専門の評価者です。
評価を行う際は、以下の指示に従ってください。
文書に質問に関連するキーワードまたは意味が含まれている場合、関連性があると評価してください。
あなたの最終出力はJSON形式で、以下のみを出力してください。
{{"relevant": "yes"}} または {{"relevant": "no"}}"""

EVAL_HUMAN = """
検索された文書:
{document}
与えられた質問:
{question}"""

OPT_SYSTEM = """
質問の再構成者として以下のタスクを実行してください。
以下の質問を、ウェブ検索向けに最適化されたより良いバージョンに改善する。
質問を分析し、その背後にある意図/意味を推論する。"""

OPT_HUMAN = """
質問:
{question}
改善された質問を作成してください。
改善された質問だけを最大で300字で出力してください。"""

ANS_SYSTEM = """
あなたは質問応答タスクのアシスタントです。
質問に答えるために、取得した以下の文脈情報を使用してください。
文脈情報が存在しない場合、または答えがわからない場合は、答えがわからないと伝えてください。
提供された文脈にない限り、答えをでっち上げないでください。
質問に対して詳細かつ的を射た回答を提供してください。"""

ANS_USER = """
質問:
{question}
文脈:
{context}
回答:"""

from typing import Literal

class DocRelevance(BaseModel):
    """Evaluation of document relevance."""
    relevant: Literal["yes", "no"] = Field(description="'yes' if the document is relevant to the question, 'no' otherwise")

class AgentState(TypedDict):
    question: str
    docs: List[Document]
    relevant_docs: List[Document]
    needs_web_search: bool
    web_query: str
    web_results: List[Document]
    answer: str

class AgenticRAG:
    def __init__(
        self,
        openai_api_key: str,
        pinecone_api_key: str,
        pinecone_index_name: str,
        tavily_api_key: str,
        base_url: str = "https://openrouter.ai/api/v1",
        llm_model: str = "tngtech/deepseek-r1t2-chimera:free",
        embedding_model: str = "openai/text-embedding-3-small",
        score_threshold: float = 0.3,
        k: int = 5,
        web_k: int = 3,
        log_level: int = logging.INFO,
        verbose_output: bool = True,
    ):
        """
        Agentic RAG using LangGraph for workflow management.

        Assumes Pinecone index exists with vectors, metadata including 'title' and 'article_id'.
        """

        self.llm = ChatOpenAI(
            model=llm_model,
            api_key=openai_api_key,
            base_url=base_url,
            temperature=0,
        )

        self.embeddings = OpenAIEmbeddings(
            model=embedding_model,
            api_key=openai_api_key,
            base_url=base_url,
        )

        pc = Pinecone(api_key=pinecone_api_key)
        index = pc.Index(pinecone_index_name)
        self.vectorstore = PineconeVectorStore(index=index, embedding=self.embeddings)
        self.tavily = TavilyClient(api_key=tavily_api_key)
        self.web_k = web_k
        self.score_threshold = score_threshold
        self.k = k
        self.verbose_output = verbose_output

        self.logger = logging.getLogger(__class__.__name__)
        self.logger.setLevel(log_level)

        self._setup_prompts()
        self.graph = self._build_graph()

    def _setup_prompts(self):
        self.eval_prompt = ChatPromptTemplate.from_messages([
            ("system", EVAL_SYSTEM),
            ("human", EVAL_HUMAN),
        ])

        self.opt_prompt = ChatPromptTemplate.from_messages([
            ("system", OPT_SYSTEM),
            ("human", OPT_HUMAN),
        ])

        self.ans_prompt = ChatPromptTemplate.from_messages([
            ("system", ANS_SYSTEM),
            ("user", ANS_USER),  # As per spec
        ])

    def retrieve(self, state: AgentState) -> Dict[str, List[Document]]:
        """Retrieve top-k docs above score_threshold from Pinecone."""
        raw_results = self.vectorstore.similarity_search_with_score(state["question"], k=self.k)
        docs = []
        for doc, score in raw_results:
            if score >= self.score_threshold:
                doc.metadata['score'] = score  # Cosine similarity score (higher = more similar)
                docs.append(doc)
                if len(docs) >= self.k:
                    break

        if self.verbose_output:
            self.logger.info(f"Retrieved {len(docs)} documents")
            for i, doc in enumerate(docs, 1):
                score = doc.metadata.get('score', 0)
                content_preview = doc.page_content[:100].replace('\n', ' ') + '...'
                meta = doc.metadata
                self.logger.info(f"[{i}/{len(docs)}] Score: {score:.4f}, Title: {meta.get('title', 'N/A')}\nPreview: {content_preview}")

        return {"docs": docs}

    def evaluate_docs(self, state: AgentState) -> Dict[str, List[Document]]:
        """Evaluate relevance of each doc using LLM (yes/no) using parallel processing."""
        from concurrent.futures import ThreadPoolExecutor, as_completed

        docs = state["docs"]
        if len(docs) == 0:
            return {"relevant_docs": []}

        relevant = []
        max_workers = min(5, len(docs))

        def _eval_doc(doc: Document) -> Optional[Document]:
            try:
                chain = self.eval_prompt | self.llm.with_structured_output(DocRelevance)
                resp = chain.invoke({
                    "document": doc.page_content,
                    "question": state["question"]
                })
                return doc if resp.relevant == "yes" else None
            except Exception as e:
                self.logger.error(f"Document evaluation failed: {str(e)}")
                return None

        try:
            with ThreadPoolExecutor(max_workers=max_workers) as executor:
                futures = [executor.submit(_eval_doc, doc) for doc in docs]
                for future in as_completed(futures):
                    result = future.result()
                    if result:
                        relevant.append(result)
        except Exception as e:
            self.logger.error(f"Document evaluation process failed: {str(e)}")

        if self.verbose_output:
            self.logger.info(f"Document Evaluation (Parallel): {len(relevant)}/{len(docs)} documents relevant")
            for i, doc in enumerate(relevant, 1):
                score = doc.metadata.get('score', 0)
                content_preview = doc.page_content[:100].replace('\n', ' ') + '...'
                meta = doc.metadata
                self.logger.info(f"[{i}/{len(relevant)}] Score: {score:.4f}, Title: {meta.get('title', 'N/A')}\nPreview: {content_preview}")

        return {"relevant_docs": relevant}

    def should_web_search(self, state: AgentState) -> Dict[str, bool]:
        """Decide if web search needed: no docs or some docs filtered."""
        needs_web = len(state["docs"]) == 0 or len(state["relevant_docs"]) < len(state["docs"])
        self.logger.debug(f"TRACE should_web_search: needs_web_search={needs_web}")
        return {"needs_web_search": needs_web}

    def optimize_query(self, state: AgentState) -> Dict[str, str]:
        """Optimize question for web search using LLM."""
        chain = self.opt_prompt | self.llm | StrOutputParser()
        original_question = state["question"]
        try:
            resp = chain.invoke({"question": original_question})
            # Ensure response is string type
            optimized = resp.strip() if isinstance(resp, str) else original_question
        except Exception as e:
            self.logger.error(f"Query optimization failed: {str(e)}")
            optimized = original_question  # Fallback to original question

        if self.verbose_output:
            self.logger.info(f"Query Optimization:\nOriginal: {original_question}\nOptimized: {optimized}")

        return {"web_query": optimized}

    def web_search(self, state: AgentState) -> Dict[str, List[Document]]:
        """Perform web search with Tavily."""
        query = state["web_query"]
        if self.verbose_output:
            self.logger.info(f"Web Search : Query: {query}")

        try:
            results = self.tavily.search(query, max_results=self.web_k).get("results", [])
        except Exception as e:
            self.logger.error(f"Tavily search failed: {str(e)}")
            results = []

        web_docs = []
        for r in results:
            doc = Document(
                page_content=r["content"],
                metadata={
                    "title": r.get("title", ""),
                    "url": r.get("url", ""),
                }
            )
            web_docs.append(doc)

        if self.verbose_output:
            self.logger.info(f"Web Search: Retrieved {len(web_docs)} results")
            for i, doc in enumerate(web_docs, 1):
                title = doc.metadata.get('title', 'No title')
                raw_url = doc.metadata.get('url', '')
                decoded_url = unquote(raw_url) if raw_url else 'No URL'
                self.logger.info(f"[{i}/{len(web_docs)}] Title: {title}\nURL: {decoded_url}")

        return {"web_results": web_docs}

    def generate_answer(self, state: AgentState) -> Dict[str, str]:
        """Generate answer from relevant docs + web results."""
        relevant_docs = state.get("relevant_docs", [])
        web_docs = state.get("web_results", [])
        all_docs = relevant_docs + web_docs
        all_contents = [d.page_content for d in all_docs]

        context = "\n\n".join(all_contents) if all_contents else "No relevant context available."

        chain = self.ans_prompt | self.llm | StrOutputParser()
        try:
            resp = chain.invoke({
                "question": state["question"],
                "context": context
            })
        except Exception as e:
            self.logger.error(f"Answer generation failed: {str(e)}")
            resp = "回答を生成できませんでした。"
        self.logger.debug(f"TRACE generate_answer: Generated answer (len={len(resp)}): {resp[:100]}...")
        return {"answer": resp.strip()}

    def _build_graph(self):
        """Build LangGraph workflow."""
        workflow = StateGraph(AgentState)

        workflow.add_node("retrieve", self.retrieve)
        workflow.add_node("evaluate_docs", self.evaluate_docs)
        workflow.add_node("should_web_search", self.should_web_search)
        workflow.add_node("optimize_query", self.optimize_query)
        workflow.add_node("web_search", self.web_search)
        workflow.add_node("generate_answer", self.generate_answer)

        workflow.set_entry_point("retrieve")
        workflow.add_edge("retrieve", "evaluate_docs")
        workflow.add_edge("evaluate_docs", "should_web_search")

        def route_to_web(state: AgentState):
            return "optimize_query" if state["needs_web_search"] else "generate_answer"

        workflow.add_conditional_edges(
            "should_web_search",
            route_to_web,
            {
                "optimize_query": "optimize_query",
                "generate_answer": "generate_answer",
            },
        )
        workflow.add_edge("optimize_query", "web_search")
        workflow.add_edge("web_search", "generate_answer")

        return workflow.compile()

    def __call__(self, question: str) -> AgentState:
        """Run the agentic RAG pipeline."""
        if not question.strip():
            raise ValueError("質問文が空です")

        initial_state = {"question": question}
        result = self.graph.invoke(initial_state)
        return result


    def query(self, question: str) -> Dict[str, Any]:
        """Public method to perform RAG query and return answer with sources."""
        result = self(question)
        sources = []

        # Collect sources from relevant_docs
        if 'relevant_docs' in result:
            for doc in result['relevant_docs']:
                title = doc.metadata.get('title', '')
                if title:
                    sources.append(title)

        # Collect sources from web_results
        if 'web_results' in result:
            for doc in result['web_results']:
                source = doc.metadata.get('title', doc.metadata.get('title', ''))
                if source:
                    sources.append(source)

        return {
            'answer': result.get('answer', ''),
            'sources': list(set(sources))  # Remove duplicates
        }
agentic_rag_cli.py
import os
import argparse
import logging
import sys
from dotenv import load_dotenv

from agentic_rag_sample.rag import AgenticRAG

def setup_logging(log_level: str):
    """Set up logging configuration"""
    level = getattr(logging, log_level.upper(), logging.DEBUG)
    logging.basicConfig(
        level=level,
        format='%(asctime)s - %(name)s - %(levelname)s - %(message)s',
        handlers=[
            logging.FileHandler("agentic_rag_cli.log"),
            logging.StreamHandler()
        ]
    )

def parse_arguments():
    """Parse command line arguments"""
    parser = argparse.ArgumentParser(description='Agentic RAG CLI')
    parser.add_argument('question', type=str, nargs='?', help='User question to answer')
    parser.add_argument('--score_threshold', type=float,
                        help='Override environment SCORE_THRESHOLD')
    parser.add_argument('--k', type=int,
                        help='Override environment K value')
    parser.add_argument('--web_k', type=int,
                        help='Override environment WEB_K value')
    parser.add_argument('--log_level', type=str,
                        help='Override LOG_LEVEL (DEBUG, INFO, WARNING, ERROR)')
    parser.add_argument('--verbose', action=argparse.BooleanOptionalAction,
                        default=True, help='Enable verbose output (default: True)')
    parser.add_argument('--dump_graph', action='store_true',
                        help='Output LangGraph structure in Mermaid format and exit without processing')
    return parser.parse_args()

def main():
    try:
        # Load environment variables
        load_dotenv()

        # Parse CLI arguments
        args = parse_arguments()

        # Configure logging
        log_level = args.log_level or os.getenv('LOG_LEVEL', 'INFO')
        setup_logging(log_level)

        # Validate required environment variables
        required_env_vars = ['OPENAI_API_KEY', 'PINECONE_API_KEY', 'TAVILY_API_KEY']
        for var in required_env_vars:
            if not os.getenv(var):
                raise ValueError(f"Missing required environment variable: {var}")

        # Build configuration dictionary
        config = {
            'llm_model': os.getenv('LLM_MODEL', 'tngtech/deepseek-r1t2-chimera:free'),
            'pinecone_index_name': os.getenv('PINECONE_INDEX_NAME', 'agentic_rag_data'),
            'base_url': os.getenv('BASE_URL', 'https://openrouter.ai/api/v1'),
            'embedding_model': os.getenv('EMBEDDING_MODEL', 'openai/text-embedding-3-small'),
            'score_threshold': float(args.score_threshold or os.getenv('SCORE_THRESHOLD', 0.3)),
            'k': args.k or int(os.getenv('K', 5)),
            'web_k': args.web_k or int(os.getenv('WEB_K', 3)),
            'verbose_output': args.verbose
        }

        # Initialize RAG system
        logging.info("Initializing AgenticRAG system")
        rag = AgenticRAG(
            openai_api_key=os.getenv('OPENAI_API_KEY'),
            pinecone_api_key=os.getenv('PINECONE_API_KEY'),
            tavily_api_key=os.getenv('TAVILY_API_KEY'),
            **config
        )

        if args.dump_graph:
            print("# Mermaid Flowchart Syntax\n")
            print(rag.graph.get_graph().draw_mermaid())
            exit(0)

        if not args.question:
            raise ValueError("Question argument is required when not using --dump_graph")

        # Execute query
        logging.info(f"Processing question: {args.question}")
        result = rag.query(args.question)

        # Output result
        print("\nAnswer:")
        print(result['answer'])
        if 'sources' in result:
            print("\nSources:")
            for source in result['sources']:
                print(f"- {source}")

    except Exception as e:
        logging.error(f"Operation failed: {str(e)}", exc_info=True)
        exit(1)

if __name__ == "__main__":
    main()
UnitTestもClineに実行させる
以下の様なプロンプトで
- テストプログラム実装
- テスト実行
をお願いしました。
とりあえず、面倒な作業は全部やってくれるますね。
- src/agentic_rag_sample/rag/agentic_rag.py を読み込んでください。
- pytest で単体テストを実装してください。tests/test_agentic_rag.py に生成してください。
- 以下の観点をすべて考慮して、pytest の unit test を生成してください。
観点:
1. 正常系(代表値・境界値・複数パターン)
2. 異常系(不正型・None・例外スローなど)
3. 境界値(0,1,最小値・最大値・閾値前後)
4. 戻り値のフォーマット・型の整合性
Grok 4、令和6年行政書士試験に挑戦したら191点で合格した
Grok 4、令和6年行政書士試験に挑戦したら191点で合格した
xAIの最新モデル「Grok 4」に令和6年行政書士試験を解かせてみました。
結果 191点(300点満点)
・法令択一 108点
・法令記述 15点
・一般知識 68点
一般知識は完璧、記述は「被告=国」「保全のため」の一言で減点されるなど、めっちゃ人間らしいミス連発(笑)
Grok 4を使ってみたい方はこちら → https://x.ai/grok
